阅读信息
- 内容类型:教程
- 难度:入门
- 适合谁:希望在 Linux、WSL2 与远程服务器上提升命令行效率的开发者。
- 读完后:在真实代码库中用 rg 完成文本、文件类型、上下文和隐藏内容搜索,并能解释为何某些文件未被搜索。
- 依据版本:ripgrep 15.2.0
- 验证日期:2026-09-11
在真实代码库中搜索时,传统的 grep -R 往往只是繁琐操作的起点:你不得不手动添加 --exclude-dir={.git,node_modules,target} 跳过与业务无关的构建产物,追加参数防止把几兆的二进制或压缩包打满终端,最后再人工补充行号与彩色高亮:
# 传统 grep 在现代项目中容易变得冗长
grep -rn --exclude-dir={.git,node_modules,dist,build} 'connect_timeout' ./srcripgrep(命令为 rg)将这些符合开发工程直觉的行为收敛为了开箱即用的默认规则:
rg 'connect_timeout'它默认开启递归搜索、多线程并行遍历、利用 SIMD 优化文本匹配,并原生遵守 .gitignore 与隐藏文件规范。它的价值不仅在于比传统工具快若干倍,更在于默认输出精准收敛在开发者关心的有效源码集合中。
本文核验基于 ripgrep 15.2.0(启用 PCRE2 特性),在 Ubuntu 24.04 LTS / WSL2 环境下完成可复现验证。
1. 安装与版本核对#
Ubuntu / Debian 安装#
Ubuntu 24.04 官方软件仓库已直接提供原生打包:
sudo apt update
sudo apt install -y ripgrep
rg --version预期输出验证:
ripgrep 15.2.0
-features: ...
若需要 PCRE2(支持前瞻/后顾正则)或希望使用最新正式版,可以从官方 GitHub Releases 直接下载 .deb 预编译包或使用 mise install ripgrep 安装。
2. 掌握搜索的五个核心维度#
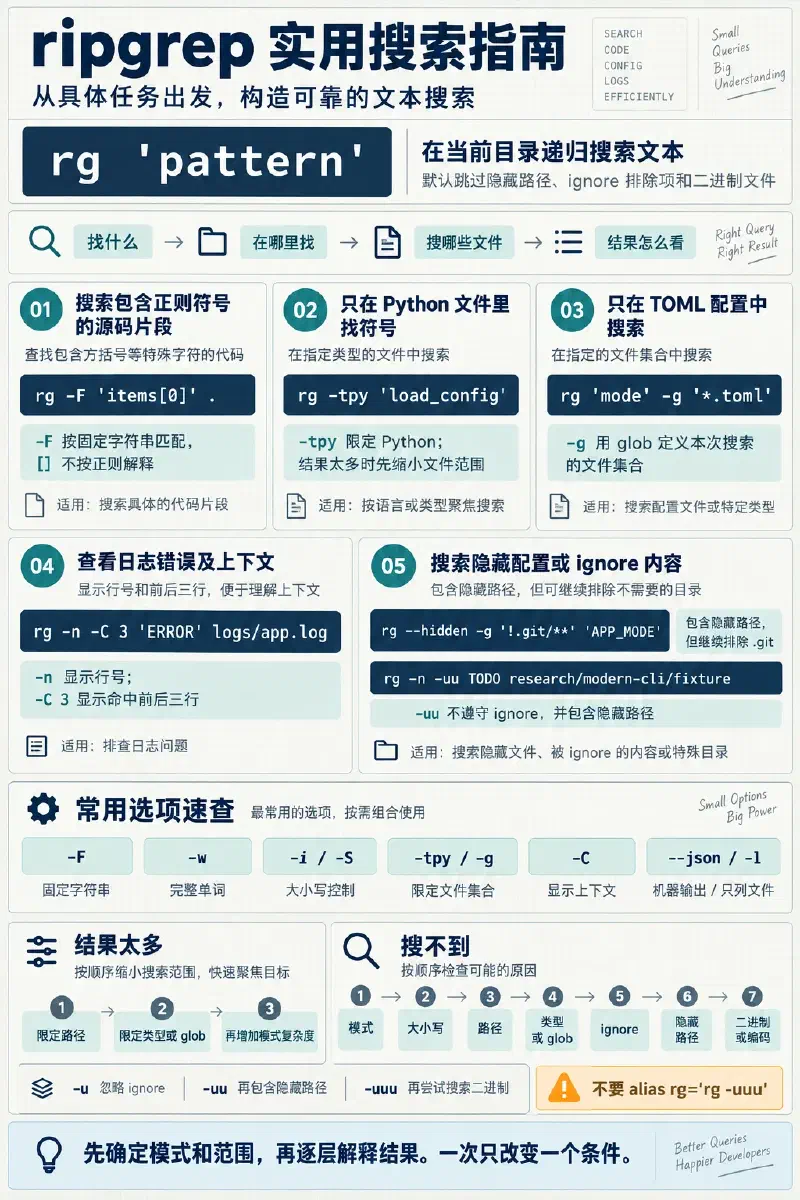
日常搜索不需要死记几十个开关,只需围绕五个正交维度自由组合:
1. 模式(Pattern):正则与纯字面量#
rg 的搜索模式默认是正则表达式。但在搜代码时,括号、中括号与指针符号极为常见,如果不加控制会被当作正则元字符解析:
# 默认正则搜索(容易因特殊符号报错或非预期匹配)
rg 'std::vector<int>'

# 强制作为纯字面量搜索(极为高频且安全)
rg -F 'std::vector<int>'
rg -F 'items[0]'- 全词匹配(
-w / --word-regexp): 只匹配独立的单词边界,避免搜cat时命中了category或concatenate:rg -w 'status' - 大小写匹配(
-i与-S):-i / --ignore-case:完全忽略大小写;-S / --smart-case(推荐):如果输入的 pattern 全部是小写字符,则自动忽略大小写;一旦输入包含任意一个大写字母,立即切换为严格区分大小写。
2. 范围(Scope):收窄搜索路径#
明确指定目标子目录或单文件,永远比在大仓根目录下全量扫描更快:
# 仅在 src/api 目录下搜索
rg 'handle_request' src/api

# 针对单个文件搜索
rg 'DEBUG' logs/app.log
3. 类型与文件名过滤(Type & Glob)#
不用在管道后接 grep 进行二次过滤,rg 内置了丰富的文件类型识别机制:
# 仅在 Python 文件中搜索
rg -tpy 'def run'

# 排除 Rust 文件(-T 表示排除类型)
rg -Trust 'main'

# 查看当前版本支持的所有文件类型别名
rg --type-list
对于非标准后缀或复合路径,使用 -g / --glob(遵循 gitignore 匹配语法):
# 仅搜索 yaml 与 json 配置文件
rg 'database_url' -g '*.{yaml,yml,json}'

# 搜索时排除所有 vendor 目录下的内容
rg 'TODO' -g '!vendor/**'
4. 上下文(Context):理解代码逻辑而不仅看一行#
排查异常时,孤立的错误行往往缺乏信息量。通过上下文参数查看前后关联:
# 显示命中行以及其前后各 3 行内容
rg -n -C 3 'NullPointerException' logs/app.log

# 仅显示命中行前 2 行(Before)
rg -n -B 2 'panic!' src/

# 仅显示命中行后 5 行(After)
rg -n -A 5 'func main()' src/
-n 会显式输出行号,这在结合编辑器跳转定位时必不可少。
5. 输出格式(Output):给人看还是给脚本读#
rg 会自动检测输出是否连接到 TTY 终端。如果输出到终端,默认启用高亮色彩和分块排版;如果进入管道或重定向,会自动关闭色彩并以 文件:行号:内容 输出。
# 仅列出包含匹配项的文件路径(不输出行内容)
rg -l 'DB_PORT'

# 统计每个文件中匹配出现的次数
rg -c 'ERROR'

# 输出标准 JSON 流,适合下游脚本精确解析字段
rg --json 'timeout'
3. 默认忽略模型:为什么有些文件“搜不到”#
许多初学者在使用 rg 时会疑惑:“我的文件明明在那里,为什么搜不到?”这通常不是程序 Bug,而是触发了 ripgrep 的过滤漏斗机制。
核心过滤层级顺序#
rg 在遍历文件系统时,会严格按以下优先级逐层跳过文件:
.gitignore规则:从当前目录向上递归检索的所有 Git 忽略规则;.git/info/exclude:仓库专有的本地排除规则;- 全局 Git 忽略文件:系统配置的
core.excludesFile; .ignore规则:专供rg(以及ag)识别的忽略文件,优先级高于.gitignore;- 隐藏文件与目录:文件名以
.开头的文件(如.env、.bashrc、.config/); - 二进制文件:通过检测文件头部是否含有 NUL 字节自动识别,避免乱码冲刷终端;
- 符号链接(Symlinks):默认不跟踪目录软链接,防止死循环与重复扫描。
逐级放宽梯子(-u 参数链)#
当需要搜索被忽略的内容时,使用 -u / --unrestricted 参数逐步打开闸门:
rg         # 默认模式:遵守 gitignore,跳过隐藏项,跳过二进制,不跟符号链接
rg -u      # 一级放宽(--no-ignore):不再遵守 ignore 规则,搜索 build/dist 产物
rg -uu     # 二级放宽(--no-ignore --hidden):再把隐藏文件(.env 等)纳入搜索
rg -uuu # 三级放宽(--no-ignore --hidden --binary):连同二进制内容一并搜索- 搜索隐藏配置文件(保持跳过编译产物):
rg --hidden 'API_KEY' - 显式跟随符号链接:
rg -L 'service_name'
反模式警告:切勿在 Shell 中配置
alias rg="rg -uuu"!这会彻底破坏 ripgrep 的设计初衷,把本该过滤掉的数 GiB 临时构建产物和二进制全部拉入内存匹配,导致终端卡死与噪声泛滥。
4. 三个端到端实操场景#
场景一:初接手陌生项目,梳理关键接口与调用链#
当你面对一个庞大的未读仓库,需要梳理配置加载逻辑:
# 1. 查找函数定义的精确位置(全词匹配)
rg -n -w 'init_database'

# 2. 如果命中数达到上百条,收窄至核心逻辑源码(排除测试用例与 mock)
rg -n -w 'init_database' -g '!*test*' -g '!*mock*'

# 3. 查看该调用处的上下文与参数传入
rg -n -C 4 'init_database\(' src/预期收益:无需等待 IDE 建立耗时数分钟的语义索引,即可以亚秒级速度勾勒出该函数的上下游拓扑。
场景二:突发故障追查,多模式筛选应用日志#
排查服务突发 502 错误,需要在数万行日志中快速定位异常:
# 忽略大小写,利用正则匹配多种错误标记,并输出前后 2 行上下文
rg -n -i -C 2 'panic|fatal|out of memory|timeout' logs/app.log
如果日志行极长(例如包含巨型 JSON 或 Base64 数据),为防止终端被超长行撑爆,使用 --max-columns 限制单行输出字符数:
rg -n -M 120 'ERROR' logs/app.log场景三:技术债务清查与脚本条件判断#
在提交代码前检查残留标记:
# 检查当前工程中未完成的债务标记
rg -n 'TODO|FIXME|HACK' src tests
在 Shell 自动化脚本或 Git Pre-commit Hook 中使用 rg 时,必须利用其标准退出状态码:
0:找到了匹配项;1:未找到任何匹配项(正常无结果);2:运行出错(如参数错误、权限不足或目录不存在)。
结合 -q / --quiet 实现静默断言:
if rg -q 'FIXME' src/; then
    echo "提交被拦截:检测到代码中包含未清理的 FIXME 标记!" >&2
    exit 1
fi
5. rg、grep 与 git grep 的职责边界#
三者各有优势,了解其边界能让你在任何环境下都游刃有余:
| 维度 | ripgrep (rg) | GNU / POSIX grep | git grep |
|---|---|---|---|
| 核心使用场景 | 日常开发、代码库交互式快速搜索、大仓排障 | 管道数据过滤、跨平台 POSIX 脚本、最小环境 | 仅对 Git 跟踪文件搜索、历史提交/分支搜索 |
| Ignore 规则 | 默认原生识别 .gitignore、.ignore | 无默认识别,必须手动配置参数排除 | 仅搜索 Git 索引库内的文件 |
| 性能机制 | Rust 多线程并行、SIMD 优化、内存映射 | 单线程顺序流式匹配(利用 Boyer-Moore) | 针对 Git 树内对象多线程并发检索 |
| 符号链接 | 默认跳过(可通过 -L 开启) | 需根据 -r 或 -R 区分是否跟随 | 仅处理 Git 跟踪的链接对象 |
| 环境普适性 | 需额外安装预编译二进制或软件包 | 绝大多数 UNIX 系统内置,无任何额外依赖 | 依赖环境中已安装 git 工具链 |
分工原则:
- 人在终端敲键盘时,优先用
rg; - 编写需要分发给第三方运行的通用 Shell 脚本时,坚持使用标准
grep; - 需要在未检出的历史 Commit 或特定分支中搜索代码时,使用
git grep 'pattern' <commit_hash>。
6. 配置文件持久化:替代脆弱的 Alias#
如果你希望默认开启某些参数(例如总是开启 --smart-case),不要使用 Shell 别名,而应使用官方支持的独立配置文件。
- 创建配置文件
~/.config/ripgrep/config:# 总是启用智能大小写 --smart-case # 默认限制过长行的显示宽度 --max-columns=200 # 自定义文件类型定义 --type-add web:*.{html,css,js,ts,jsx,tsx}* - 在
~/.bashrc中声明环境变量:export RIPGREP_CONFIG_PATH="$HOME/.config/ripgrep/config"
这样配置的好处是:任何通过终端运行的 rg 都会继承统一规则,同时保留了原生命令行参数解析能力,不会在与其他脚本管道协作时产生非预期冲突。
7. 最小可执行练习#
通过以下 5 分钟实操,在临时沙箱中完整体验从默认过滤到逐级放宽的全过程:
# 1. 建立临时测试目录
rm -rf /tmp/rg-sandbox && mkdir -p /tmp/rg-sandbox/{src,ignored,.hidden}
cd /tmp/rg-sandbox

# 2. 模拟文件与 ignore 规则
echo "function find_me() {}" > src/app.js
echo "find_me in ignored" > ignored/cache.txt
echo "find_me in secret" > .hidden/secret.txt
echo "ignored/" > .gitignore

# 3. 验证默认过滤:仅应输出 src/app.js
rg 'find_me'

# 4. 验证 -u 放宽 ignore:此时应额外输出 ignored/cache.txt
rg -u 'find_me'

# 5. 验证 -uu 放宽隐藏项:此时三处全部输出
rg -uu 'find_me'

# 6. 清理沙箱
cd ~ && rm -rf /tmp/rg-sandbox
完成本练习后,你便能清晰解释每一次搜索输出的边界,并能通过 -F、-S、-u 精确控制搜索范围。
参考资料#
本文采用 CC BY-NC-SA 4.0 许可。