阅读信息
- 内容类型:教程
- 难度:中级
- 适合谁:希望在 Linux、WSL2 与远程服务器上提升命令行效率的开发者。
- 读完后:设计、执行并解释一次 rg 与 grep 或两个等价命令的可重复基准,识别实验设计失效的情况。
- 依据版本:hyperfine 1.20.0; local verification 1.18.0
- 验证日期:2026-09-11
“我在终端跑了一次,A 工具明显比 B 工具快”,这几乎永远不能作为有说服力的性能结论。
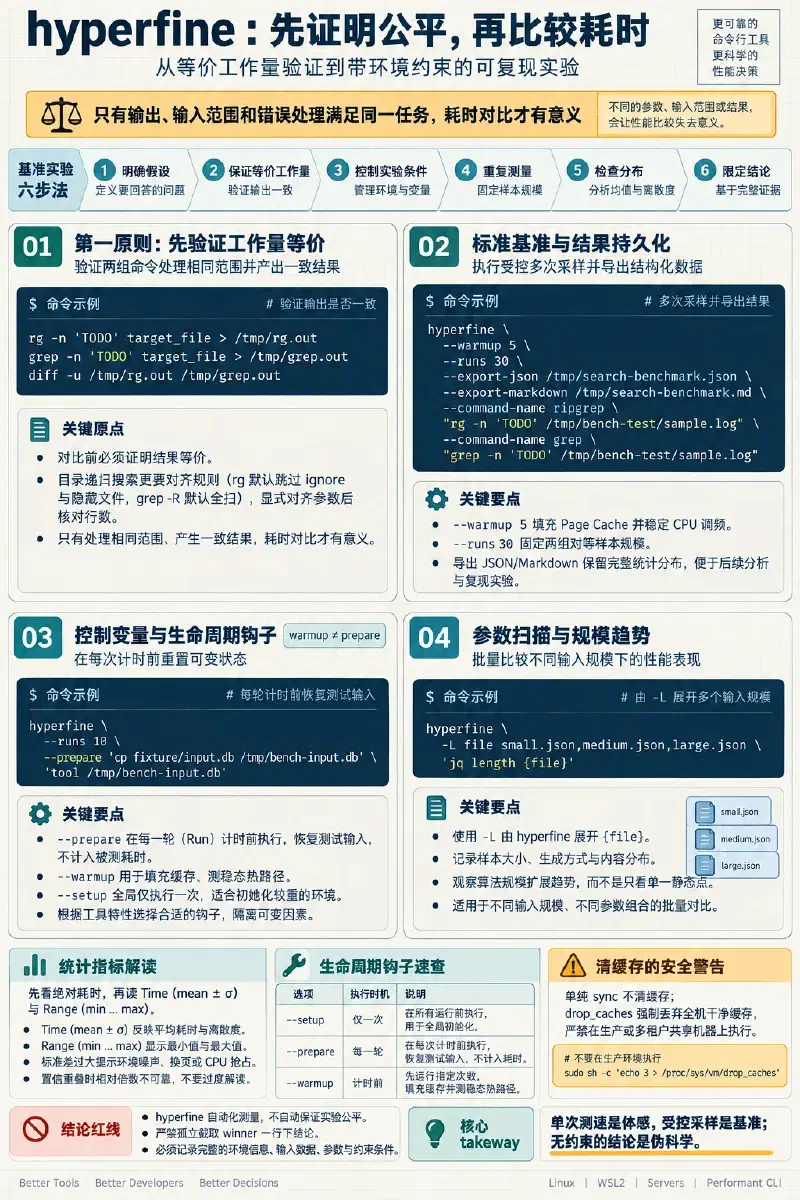
单次执行命令的耗时,会被进程冷启动、操作系统的文件页缓存(Page Cache)、CPU 动态调频(P-State / Turbo Boost)、后台任务以及终端自身的渲染延迟严重干扰。hyperfine 能够自动化完成冷预热、多次重复采样、离散度统计以及跨命令的相对对比,但它无法替你解决实验设计是否公平的前置问题。
真正可靠的基准测试工作流应当是:
明确实验假设 → 确保等价任务负载与输入 → 控制外部缓存与噪声
         → 重复采样与预热 → 审查统计分布与异常值 → 导出带环境约束的结论
本文以 hyperfine 1.20.0 为规范版本,本地实测环境使用 1.18.0;文中的具体毫秒数值仅用于说明统计结果的阅读方法,不代表 1.20.0 的绝对性能。
1. 安装与最简测量对比#
按照官方安装指南安装后,首先验证版本:
hyperfine --version执行最简单的单命令测时:
hyperfine 'sleep 0.05'hyperfine 会自动估算命令执行速度并进行若干次运行,最终输出类似下方的统计面板:
Benchmark 1: sleep 0.05
  Time (mean ± σ):      53.2 ms ±   1.2 ms    [User: 1.1 ms, System: 2.1 ms]
  Range (min … max):    51.0 ms …  55.8 ms    45 runs
输出包含了算术平均值(mean)、标准差(σ)、最小与最大区间(min … max)、用户态与内核态时间(User / System),以及自适应确定的执行轮数。
传统计时工具的定位#
如果你只是想粗略获知一个运行数十分钟的批处理脚本大概耗时多久,或者重点关注峰值常驻内存(Max RSS),不需要进行多命令对比或微秒级微基准,内置的 GNU time 往往更为直接:
/usr/bin/time -v ./long-running-job.sh/usr/bin/time -v 会直接给出 Elapsed Wall Clock 时间、用户/系统态 CPU 时间以及上下文切换和最大内存。而 hyperfine 的长处在于:自动化多次重复采样、消除偶发扰动、控制前后状态,以及跨工具的相对速度评测。
2. 第一原则:先证明两组命令执行的是等价工作量#
对比性能之前,最容易犯的错误是“拿名字相似但行为完全不同的两个命令做比较”。
例如,开发者常想对比 ripgrep(rg)与 GNU grep(grep)的搜索性能:
# 表面看起来在做相同的事:
rg 'TODO' target_file
grep 'TODO' target_file
在启动基准测试前,必须首先验证它们的输出结果是否一致:
rg 'TODO' target_file > /tmp/rg.out
grep 'TODO' target_file > /tmp/grep.out
diff -u /tmp/rg.out /tmp/grep.out
如果比较的是目录递归搜索(如 rg 'PATTERN' . 对比 grep -R 'PATTERN' .),工作量差异会更加隐蔽:
- 默认规则不对等:
rg默认会自动遵守.gitignore并跳过隐藏目录(如.git)及二进制文件;而grep -R会递归遍历包括.git内部打包对象在内的所有文件。如果直接比较,grep实际扫描的数据量往往比rg大数十倍,这测出的不是搜索算法优劣,而是“有没有忽略无关文件”。 - 对齐规则后再测:若要公平对比目录递归搜索,要么显式让
rg扫描全部内容(rg -u -u -u),要么显式让grep排除版本控制目录(grep -R --exclude-dir=.git),并在运行前核对两者的行数与命中条目完全一致。
3. 设计一次可复现的完整小实验#
我们以对比 rg 与 grep 在一个固定样本文件中的搜索耗时为例。
准备可复现样本#
在临时目录创建一个约 10 万行的测试文件,其中包含稀疏分布的目标关键字:
mkdir -p /tmp/bench-test
python3 -c "
for i in range(100000):
    if i % 1000 == 0:
        print(f'Line {i}: TODO fix this bug')
    else:
        print(f'Line {i}: normal log entry message content')
" > /tmp/bench-test/sample.log执行基准测试#
使用以下命令发起标准实验:
hyperfine \
  --warmup 5 \
  --runs 30 \
  --export-json /tmp/search-benchmark.json \
  --export-markdown /tmp/search-benchmark.md \
  --command-name ripgrep \
  "rg -n 'TODO' /tmp/bench-test/sample.log" \
  --command-name grep \
"grep -n 'TODO' /tmp/bench-test/sample.log"参数解析:#
--warmup 5:正式采样前先盲跑 5 次。这使得操作系统的 Page Cache 充分加载该文件,同时让 CPU 调频策略进入活跃状态,避免第一轮运行因为冷启动而出现畸高耗时。--runs 30:固定测量正好 30 轮,保证两组命令拥有完全相同的统计样本规模。--command-name:为每个命令指定可读别名,避免在汇总表格中打印长命令。--export-json/--export-markdown:将完整的采样原始值和统计表格持久化保存。
实际文章环境在 WSL2 本机环境下对短搜索命令的独立测量得到约 6.5 ms ± 0.8 ms 的基线。该数字完全受限于宿主机当时硬件、WSL2 虚拟化开销与文件缓存状态,读者在不同机型或物理 Linux 上运行会得到不同的绝对时间。
4. 统计指标解读:均值、离散度与异常值#
hyperfine 最终会打印出一份统计结果与 Summary:
Summary
  ripgrep ran
    X.XX ± Y.YY times faster than grep
在把这些数字写进技术分享或选型报告之前,必须正确理解每一项统计学含义:
1. 算术平均值(Mean)与极端值(Min / Max)#
均值反映了多次采样的中心位置,但并不等于用户在真实生产环境中每次调用都能得到的固定延迟。Min 代表系统在几乎没有外界干扰下的理想能力;而 Max 则暴露了最坏长尾。
2. 标准差(σ)与环境噪声#
标准差衡量了数据的波动幅度。如果均值是 10 ms,标准差达到 4 ms(即 10 ms ± 4 ms),说明单次运行间存在高达 40% 的巨大抖动。
- 此时 hyperfine 通常会在末尾打印
Warning: Statistical outliers were detected警告; - 造成大离散度的常见原因包括:后台有编译或备份任务抢占 CPU、系统正在发生内存换页、或者命令涉及了非确定性的网络 I/O;
- 在离散度过大时,单纯看相对加速倍数(Faster than)是不可靠的,因为两组采样的置信区间存在大量重叠。
3. 统计学加速比的局限#
“X ran 1.45 ± 0.12 times faster than Y”仅表示在这组特定参数与样本分布下测得的相对比值。如果绝对耗时是从 0.3 ms 降低到 0.2 ms,即使提升了 1.5 倍,在人类交互体感或整个构建流程中也几乎无法察觉。技术选型必须综合权衡工具可移植性、依赖成本与绝对收益。
5. 控制变量:warmup、prepare、setup 与 cleanup#
很多初学者容易混淆预热与准备参数。hyperfine 提供了精细的生命周期控制钩子:
| 参数 | 执行时机与频率 | 计入耗时? | 典型适用场景 |
|---|---|---|---|
-w, --warmup N | 每个命令测试开始前执行 N 次 | 否 | 填充文件系统缓存、预热 JIT/分支预测器 |
-s, --setup CMD | 在某个命令的全部测试轮次开始前执行 1 次 | 否 | 准备临时目录、全局编译测试产物 |
-p, --prepare CMD | 在每一轮(Run)计时前均执行 1 次 | 否 | 清空或重置被测数据文件、重置数据库状态 |
-c, --cleanup CMD | 在某个命令的全部测试轮次完成后执行 1 次 | 否 | 删除测试中生成的临时大文件或恢复配置 |
冷缓存与热缓存实验#
--warmup 测出的是**热缓存(Hot Cache)**下的稳态性能。
如果你的真实业务场景就是处理“每次都可能未命中缓存的冷数据”,就需要设计冷缓存实验。但在 Linux 中,真正的清空页缓存需要特权操作:
# 必须使用 sudo 向 drop_caches 写入:
sync; echo 3 | sudo tee /proc/sys/vm/drop_caches
你可以通过 --prepare 在每轮测量前执行清缓存:
hyperfine \
  --prepare 'sync; echo 3 | sudo tee /proc/sys/vm/drop_caches' \
  --runs 10 \
'grep -R pattern /large/data'实验伦理与安全警告:
- 单纯执行
sync不会清空内核页缓存,它仅将脏页刷写到磁盘,缓存仍然驻留在 RAM 中;drop_caches会强制丢弃全系统的干净页缓存,会使得整台主机上所有正在运行的数据库、Web 服务和其他进程全面陷入冷 I/O;- 严禁在共享开发机、生产服务器或多租户环境中运行带
drop_caches的基准测试;且频繁在 SSD 上触发整机冷读取会加速磨损。
6. 参数扫描与列表:比较规模趋势#
性能分析往往不能仅停留在“某一个固定文件大小”,而需要观察随输入规模增长的缩放曲线。hyperfine 内置了参数化支持:
1. 整数范围扫描(--parameter-scan)#
用于测试并发线程数、批量大小等整型变量。使用 {VAR} 占位符:
hyperfine \
  --parameter-scan threads 1 8 \
  'make -j {threads}'
hyperfine 会依次测量 make -j 1 到 make -j 8 并输出横向比对。
2. 离散参数列表(-L, --parameter-list)#
用于测试不同的编译器、不同尺寸的输入文件或不同的配置选项:
hyperfine \
  -L file small.log,medium.log,large.log \
  'grep "error" {file}'
Shell 引用关键规则:包含
{file}占位符的命令字符串,必须用单引号括起来交给 hyperfine。如果直接写在未引用的 Bash 命令行中,Bash 会试图在解析时自行展开变量,导致 hyperfine 无法正确替换参数。
7. Shell 开销、非零退出码与输出重定向#
1. 排除 Shell 进程启动成本#
hyperfine 默认会通过系统默认 Shell(如 /bin/sh)来执行被测命令。这意味着测量耗时中包含了一次 fork 和 exec sh 的开销(通常约 1–3 ms)。
- 对于耗时数百毫秒的命令,这部分开销可以忽略;
- 但如果测试的是极快的高频工具(如对比某个 C 语言内联函数与 Rust 基础命令),这 2 毫秒可能占了 90% 的耗时。
- 可以使用
-N或--shell=none跳过 Shell 直接执行二进制:
hyperfine -N 'ls' 'eza'注:启用 --shell=none 后,命令字符串中不能包含 Bash 管道 |、重定向 > 或 &&。
2. 退出码陷阱:搜索未命中的非零返回#
在 Unix 约定中,grep 和 rg 在未找到匹配项时会返回退出码 1;其他工具遇到非法参数时可能返回 2。
默认情况下,hyperfine 一旦检测到被测命令返回非零退出码,会立即中断并报错退出:
Error: Command terminated with non-zero exit code: 1.
Use the '-i'/'--ignore-failure' option if you want to ignore this.
如果你设计的基准测试本身包含“验证无匹配时的扫描速度”,或者被测命令通过非零状态传递业务信号,必须显式附加 -i 或 --ignore-failure 参数:
hyperfine -i "grep 'nonexistent_keyword' /tmp/bench-test/sample.log"3. 输出重定向与终端管道#
hyperfine 默认会将命令的标准输出和标准错误自动丢弃(等价于重定向到 /dev/null)。
但需要警惕某些命令行工具的内部逻辑:许多工具会调用 isatty(STDOUT_FILENO) 检测标准输出是否为终端。如果输出到终端,它们可能开启彩色渲染和行缓冲;如果检测到 /dev/null,它们可能切换为块缓冲甚至跳过部分高开销的字符串格式化。
- 如果需要保证命令像接入管道一样工作,使用 hyperfine 的
--output=pipe; - 不要写出
hyperfine "cmdA > /dev/null" "cmdB"这种一边重定向另一边不重定向的倾斜实验。
8. 完整结果导出与实验元数据记录#
绝不要在报告或 Pull Request 中只贴一张截断的“Summary: A is 1.5x faster”截图。一份可复核的基准结果必须具备完整的原始数据与软硬件元信息。
执行导出:
hyperfine \
  --warmup 5 \
  --runs 50 \
  --export-json /tmp/benchmark-result.json \
  --export-markdown /tmp/benchmark-result.md \
  --command-name "ripgrep" "rg -n 'TODO' /tmp/bench-test/sample.log" \
  --command-name "grep" "grep -n 'TODO' /tmp/bench-test/sample.log"
在提交基准报告时,必须同步附带当时的上下文环境:
# 记录测试环境上下文
uname -a
hyperfine --version
rg --version | head -n 1
grep --version | head -n 1
并在实验说明中补充:
- 测试数据的大小、行数与存储介质(如“ext4 虚拟磁盘”还是“通过 9P 挂载的 Windows NTFS 分区”);
- 主机供电状态(插电还是电池供电,避免 CPU 动态降频带来干扰);
- 是否存在其他高负载后台任务。
9. 实验设计失效的典型反面模式#
在审查或设计性能对比时,出现以下情况的实验结果均属无效:
反模式一:跨文件系统边界混测#
在 WSL2 中,放在 Linux 原生虚拟硬盘(/home/user/...,基于 ext4)中的文件,与放在 Windows 宿主盘(/mnt/c/...,通过 9P/virtio-fs 跨系统挂载)中的文件,其元数据与 I/O 吞吐性能差距可达 5 至 20 倍。如果命令 A 读取 /home,命令 B 读取 /mnt/c,测试结果完全被跨系统文件传输机制主导。
反模式二:把热缓存测得的数字宣称为冷启动速度#
在启用了 --warmup 10 的前提下测出某工具只要 5 毫秒,随后在博客中宣称“该工具在用户点击时瞬时响应只需要 5 毫秒”。预热后的测试只能证明其在内存页缓存击中时的计算速度;若要证明冷启动体验,必须独立设计冷缓存方案。
反模式三:一边进行微信会议/后台编译一边做微基准#
桌面后台的实时解压、杀毒软件周期性扫描、操作系统自动更新或笔记本电脑过热降频(Thermal Throttling),都会直接体现为极大离散度(σ)。噪声大于两者均值差异时,任何优劣结论在统计学上均不成立。
10. 基准测试自检复核清单#
在对外公布任何基准数据前,逐项核对以下清单:
- 假设可证伪:有清晰的技术假设(如“在单文件热缓存场景下,SIMD 加速搜索算法相比普通匹配算法能显著缩短时间”);
- 工作量等价:两组命令对完全相同的输入文件产生语义一致的输出结果,已通过
diff校验; - 缓存与预热状态明确:明确区分了热缓存(Hot Cache)与冷缓存(Cold Cache),并正确配置了
--warmup; - 生命周期钩子得当:需要还原数据状态的场景正确使用了
--prepare,且准备命令不计入基准耗时; - 异常与退出码已处理:已知会产生非零退出的命令配置了
-i,未发生意外夭折; - 离散度受控:标准差 σ 处于合理区间,不存在大量异常值或未解释的环境噪声;
- 环境元数据完备:机器硬件、操作系统、内核版本、工具版本及存储路径类型均完整记录。
参考资料#
- hyperfine 官方代码仓库与文档
- hyperfine 1.20.0 Release 说明
- hyperfine 参数手册 (Manpage)
- GNU time 官方手册
- Brendan Gregg:基准测试的常见错误与陷阱
本文采用 CC BY-NC-SA 4.0 许可。