阅读信息
- 内容类型:教程
- 难度:入门
- 适合谁:希望在 Linux、WSL2 与远程服务器上提升命令行效率的开发者。
- 读完后:从 JSON 和 JSONL 中取字段、遍历、筛选、重组并用退出状态驱动 Shell 判断,形成一条完整数据流水线。
- 依据版本:jq 1.8.2
- 验证日期:2026-09-11
JSON 是具有严格语法、类型和层级嵌套的数据格式,而不是“恰好带许多双引号的普通文本”。在命令行中如果使用 grep 或 sed 提取字段,一旦服务端调整字段顺序、增加缩进换行,或在不同层级存在同名字段,文本正则就会迅速失效或静默截取错误内容。
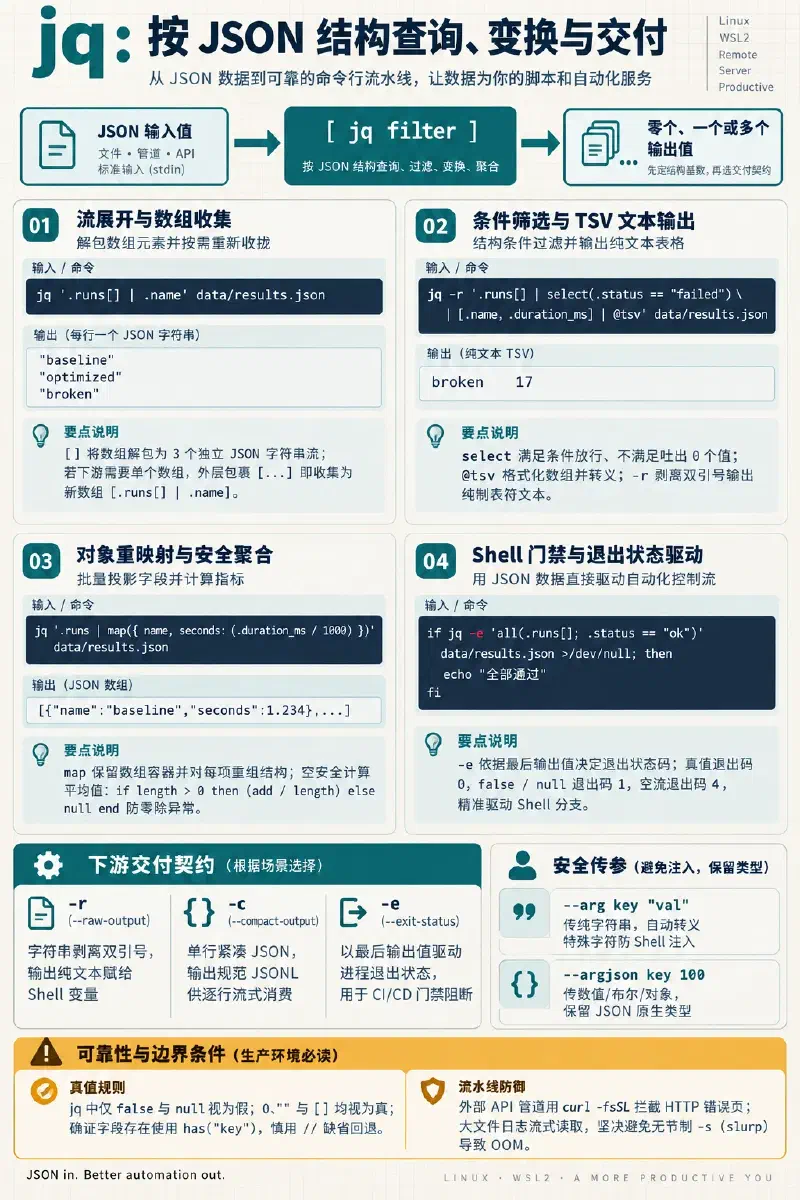
jq 将 JSON 视为结构化数据,其核心计算模型是过滤器流(filter stream):
JSON 输入值 ──▶ [ jq filter ] ──▶ 0 个、1 个或多个 JSON 输出值在 jq 中,过滤器不仅能读取字段,还能遍历容器、筛选条目、变换结构与重新构造数据。多个过滤器之间通过管道符 | 连接,但这里的 | 与操作系统进程级管道不同:它是在 jq 内部将左侧表达式吐出的每一个独立值,依次作为输入喂给右侧表达式。
本文以 jq 1.8.2 为规范与实测版本。
1. 采用判断与安装#
何时采用 jq#
- 优先采用:处理 REST API 响应、容器/Kubernetes 状态、云平台 CLI 输出、结构化应用配置,以及以行分隔的 JSON Lines(JSONL)日志。
- 不建议采用:无结构的自由文本日志(用
ripgrep);需要严格模式校验或复杂业务运算的生产任务(用 Python/Node.js 或专用验证库);YAML 格式(使用针对 YAML 语法的yq)。
安装与版本确认#
在 Debian 与 Ubuntu 环境中,可以直接通过软件源安装:
sudo apt update && sudo apt install -y jq需要说明的是,Ubuntu 24.04 LTS 官方源提供的软件包版本为 1.7.1(包含发行版维护的安全修复)。如果你的开发流已配置 mise,且需要与上游最新语法、递归限制修复及安全补丁保持严格一致,可以直接通过 mise 固定 1.8.2:
mise use -g jq@1.8.2确认安装结果与版本:
jq --version预期输出:
jq-1.8.22. 最小检查与测试夹具#
. 是 jq 的最简恒等过滤器(identity filter):读取一个合法 JSON 输入,并以规范缩进着色打印。如果输入不是合法的 JSON,jq 会在 stderr 输出解析错误并返回非零状态码。
准备本次测试使用的结构数据。你可以切换至仓库内的测试目录:
cd research/modern-cli/fixture
jq . data/results.json
若在独立环境中测试,可直接准备如下内容保存为 results.json:
{
  "runs": [
    {"name": "baseline", "status": "ok", "duration_ms": 124},
    {"name": "optimized", "status": "ok", "duration_ms": 83},
    {"name": "broken", "status": "failed", "duration_ms": 17}
  ]
}
运行 jq . data/results.json 能够格式化输出完整对象。注意:语法解析成功仅代表 JSON 格式合法,并不代表业务字段满足特定契约。
3. 字段提取、数组切片与流迭代#
访问顶层与嵌套字段#
直接通过 .key 访问对象的属性:
jq '.runs' data/results.json访问数组元素使用方括号下标(索引从 0 开始):
jq '.runs[0].name' data/results.json实测输出:
"baseline"注意此时输出包含双引号,因为其类型仍是 JSON String。
数组展开迭代:[]#
[] 运算符负责解包数组,将数组内部的元素逐个释放为独立的输出值流:
jq '.runs[] | .name' data/results.json实测输出:
"baseline"
"optimized"
"broken"这里关键的心智模型变化在于:输出不是一个包含三个元素的数组,而是三个独立的 JSON 字符串。
将流重新收集为数组:[...]#
如果下游工具需要一个完整的 JSON 数组整体接收,在外层使用方括号 [...] 即可将管道流收集重构成新数组:
jq '[.runs[] | .name]' data/results.json输出:
[
  "baseline",
  "optimized",
  "broken"
]
4. 用 select 按结构筛选与文本输出#
条件筛选:select(boolean_expression)#
select(condition) 会对输入值进行求值:
- 若条件为真,将当前输入值原样透传给下游;
- 若条件为假(
false或null),则直接丢弃该值,产生 0 个输出。
筛选失败的任务:
jq '.runs[] | select(.status == "failed")' data/results.json实测输出:
{
  "name": "broken",
  "status": "failed",
  "duration_ms": 17
}提取并输出为制表符分隔文本(TSV)#
结合 -r 参数和 @tsv 内置格式化函数,将结构化数据转为 Shell 友好的表格格式:
jq -r '
  .runs[]
  | select(.status == "failed")
  | [.name, .duration_ms]
  | @tsv
' data/results.json
实测输出:
broken 17-r(--raw-output):当输出结果为 JSON 字符串时,剥离外部双引号与转义符,输出为纯文本内容。数字和布尔值原样输出。@tsv要求输入必须是一个数组,它会将数组项以 Tab(\t)分隔,并处理换行等字符转义。
5. 映射、排序与结构聚合#
map:针对数组整体的变换#
当你不希望拆散数组,而是对数组的每个元素进行一对一投影重构时,使用 map(filter):
jq '
  .runs
  | map({
      name,
      seconds: (.duration_ms / 1000),
      passed: (.status == "ok")
    })
' data/results.json
这里 { name } 是 jq 的对象字面量简写,等价于 { "name": .name }。
排序与极值获取#
按耗时排序并提取执行时间最短的记录:
jq '.runs | sort_by(.duration_ms) | first' data/results.json输出:
{
  "name": "broken",
  "status": "failed",
  "duration_ms": 17
}聚合计算与空安全#
计算成功项的平均耗时:
jq '
  [.runs[] | select(.status == "ok") | .duration_ms]
  | if length > 0 then (add / length) else null end
' data/results.json
实测输出:
103.5必须养成防御性处理空数组的习惯:真实环境的查询结果可能完全匹配不到成功项。若没有 if length > 0 保护,0 / 0 会在 jq 中引发计算异常或非预期结果。
6. 输出契约:-r、-c 与 -e#
在将 jq 接入自动化脚本时,选项的选择直接改变了下游工具面对的接口契约:
| 选项 | 全称 | 输出契约改变 | 典型应用场景 |
|---|---|---|---|
-r | --raw-output | 字符串结果不再带 JSON 双引号,直接输出原始内容 | 提取文件路径、Token、版本号赋给 Shell 变量 |
-c | --compact-output | 每个 JSON 对象/数组紧凑压缩为一行,不排版换行 | 构造 JSON Lines(JSONL)、向日志传输、批量并发管道 |
-e | --exit-status | 根据最后一次过滤输出的值决定进程退出码 | Shell 条件分支、CI/CD 自动化门禁阻断 |
-c:输出规范 JSONL#
jq -c '.runs[]' data/results.json输出为三行单行 JSON,每一行都是一个语法完备、自包含的 JSON 对象,适合通过标准管道交给 while read -r line 逐行处理。
-e:以数据驱动 Shell 决策#
依据官方手册定义,-e(--exit-status)有明确的退出状态契约:
- 退出码 0:最后一次输出的值既不是
false也不是null(即输出为真值)。 - 退出码 1:最后一次输出的值为
false或null。 - 退出码 4:整个过程中没有产生任何有效输出(空流)。
- 退出码 2:命令行参数错误或系统异常。
- 退出码 3:jq 过滤程序编译错误。
- 退出码 5:JSON 输入解析失败(如数据畸形)。
在 Shell 中使用 -e 构建判断分支:
if jq -e 'all(.runs[]; .status == "ok")' data/results.json >/dev/null; then
  echo "所有测试全部通过"
else
  exit_code=$?
  echo "存在测试失败或结构异常 (退出状态: $exit_code)"
fi
由于样本数据中包含 status == "failed" 的条目,all(...) 计算结果为 false,jq 退出状态为 1,精准进入 else 分支。
注意区分 jq 的真值规则:在 jq 中,只有 false 和 null 视为假;数字 0、空字符串 "" 以及空数组 [] 在条件判断中均被视为真。
7. 字段缺失、null、false 与类型防御#
在处理外部不确定 JSON 时,混淆缺失、null 和 false 会带来逻辑隐患:
jq '.config.timeout' input.json    # 若 config 或 timeout 不存在,输出 null
jq 'has("config")' input.json       # 严格检查当前对象中是否存在 "config" 键
jq '.enabled // true' input.json    # 备选回退符 // 将 false 和 null 均当作缺省
jq '.items[]?' input.json # ? 抑制遍历非数组类型时的报错- 缺失 vs null:访问未定义的字段在 jq 中默认求值为
null,这无法区分“该键根本不存在”与“该键存在但显式设为 null”。需确认存在性时使用has("key")。 - 回退符
//的边界:a // b表示“如果 a 不是 false 也不是 null,则取 a,否则取 b”。如果配置项中false是合法有效的值(例如{"enabled": false}),使用// true会错误地将其覆盖为true。 - 错误抑制符
?:.items[]?在.items不存在或不是数组时不会中断进程,但过度使用会掩盖 API 契约变更或拼写笔误。
在关键生产脚本中,优先显式验证必要字段与数据类型:
jq -e '
  (.runs | type == "array")
  and all(.runs[]; has("name") and has("status"))
' data/results.json >/dev/null
8. 端到端实战:API 响应与 Benchmark 汇总#
场景一:带错误检查的 HTTP 管道#
从外部 API 读取 JSON 时,必须拦截 HTTP 状态错误,防止 404 或 500 的 HTML 错误页流入 jq:
# 正确实践:利用 curl -f 拦截 HTTP 错误
response=$(curl -fsSL --max-time 15 "https://api.example.invalid/v1/health" 2>/dev/null)
if [ $? -ne 0 ]; then
  echo "HTTP 请求失败或超时" >&2
  exit 1
fi

echo "$response" | jq -e '.status == "healthy"' >/dev/null
在调试阶段,可先保存原始响应并核查结构轮廓:
curl -fsSL --max-time 15 "https://api.example.invalid/v1/health" -o response.json
jq 'keys' response.json          # 查看顶层所有键名
jq '.runs | type' response.json  # 检查目标字段类型
场景二:Benchmark 性能指标汇总#
在性能测试中,提取所有成功的运行项并计算 P95 统计或快速汇总:
jq -r '
  [.runs[] | select(.status == "ok")]
  | {
      count: length,
      total_duration_ms: (map(.duration_ms) | add),
      fastest: (sort_by(.duration_ms) | first.name)
    }
' data/results.json
实测输出:
{
  "count": 2,
  "total_duration_ms": 207,
  "fastest": "optimized"
}
9. 变量注入与 Shell 参数安全传递#
切勿使用 Shell 字符串拼接将外部变量嵌入 jq 程序:
# 危险示例:若 name 包含引号或恶意 jq 代码,会导致语法崩溃或注入漏洞
target_name='broken") | .duration_ms #'
jq ".runs[] | select(.name == \"$target_name\")" data/results.json
安全的方式是使用 jq 提供的参数绑定机制:
--arg:传参字符串#
将 Shell 变量作为纯字符串传递,jq 会自动处理所有字符转义,变量名以 $ 开头在程序内引用:
name="broken"
jq --arg target "$name" '
  .runs[] | select(.name == $target)
' data/results.json--argjson:传参数值、布尔与复杂对象#
当传入的参数需要保留数字、布尔值或 JSON 数组/对象类型时,使用 --argjson:
threshold=100
jq --argjson limit "$threshold" '
  [.runs[] | select(.duration_ms < $limit)]
' data/results.json
若混淆两者,例如使用 --arg limit "100",$limit 会作为字符串 "100" 参与比较,由于 JSON 中数字与字符串的比较规则,将产生非预期的筛选结果。
10. 内存边界与大文件处理#
jq 默认采用在内存中构建完整 AST(抽象语法树)的解析模式。
-s(--slurp)的内存代价:-s会将输入流中的全部 JSON 读入内存整合成一个大数组。面对数 GB 的日志文件,-s极易导致 OOM(内存溢出)。- 逐行流式(JSONL):对于标准的 JSON Lines 日志,jq 原生按值顺序处理,无需加
-s:此时 jq 是流式逐行读取与消费,内存开销恒定。jq -c 'select(.level == "error")' app-events.jsonl - 超大单一 JSON 文件的
--stream机制:若单一 JSON 文件极其巨大,jq 提供了--stream参数将数据切碎为路径与值的二元流事件,但其 filter 编写复杂度大幅上升。当遇到几十兆以上的单一嵌套 JSON,更推荐使用专用流式解析器或在 Python/Go 等语言中流式消费。
11. 工具分工与退路#
| 任务场景 | 首选工具 | 选择理由 |
|---|---|---|
| 交互查询、结构筛选、Shell 状态判断 | jq | 原生理解 JSON 数据类型与嵌套层级,表达式强大 |
| 自由文本日志检索、代码搜索 | ripgrep (rg) | 多线程极速扫描,对纯文本与非结构化日志效率最高 |
| YAML 配置文件读取与原地修改 | yq (如 mikefarah/yq) | 原生支持 YAML 注释保留与语法特性(注意固定实现版本) |
| 复杂业务验证、多 API 聚合、数据库联动 | 语言标准库 (Python / Node.js) | 具备完备的异常处理、日志、并发网络请求与数据验证生态 |
12. 闭环练习#
在当前环境运行以下命令检验掌握程度:
jq -e '
  [.runs[] | select(.status != "ok")]
  | length == 0
' data/results.json
echo "Exit status: $?"预期现象与复核依据#
- 命令标准输出为
false。 echo $?输出为1。- 复核逻辑:样本中存在
status == "failed"的记录,因此未通过项数组长度大于 0,length == 0求值为false。配合-e参数,当最终输出为false时,jq 依约退出状态码为 1。你能清晰解释这与“输入文件语法错误(退出码 5)”以及“过滤未产生任何输出(退出码 4)”的本质差异。
参考资料#
本文采用 CC BY-NC-SA 4.0 许可。