阅读信息
- 内容类型:教程
- 难度:中级
- 适合谁:准备在 Linux NUMA 服务器上使用 MLC 3.10 的性能工程师
- 前置知识:Linux 命令行、CPU 与 NUMA 的基本概念
- 读完后:独立完成一次 Idle 与 Loaded Latency 测量,解释曲线,并保存可比较的证据包。
- 依据版本:Intel MLC v3.10; local binary SHA-256 cd7de7ff3f73928fb2a273c01dd6cb2dffdc2dd0a77d68f9310e52016d3d24dd
- 验证日期:2026-08-23
下面这条命令看起来只是在“测内存”,实际同时定义了观察者、压力源、内存位置、流量模式、工作集和采样周期:
./mlc310 --loaded_latency \
  -c0 \
  -k1-15 \
  -j0 \
  -R \
  -b100m \
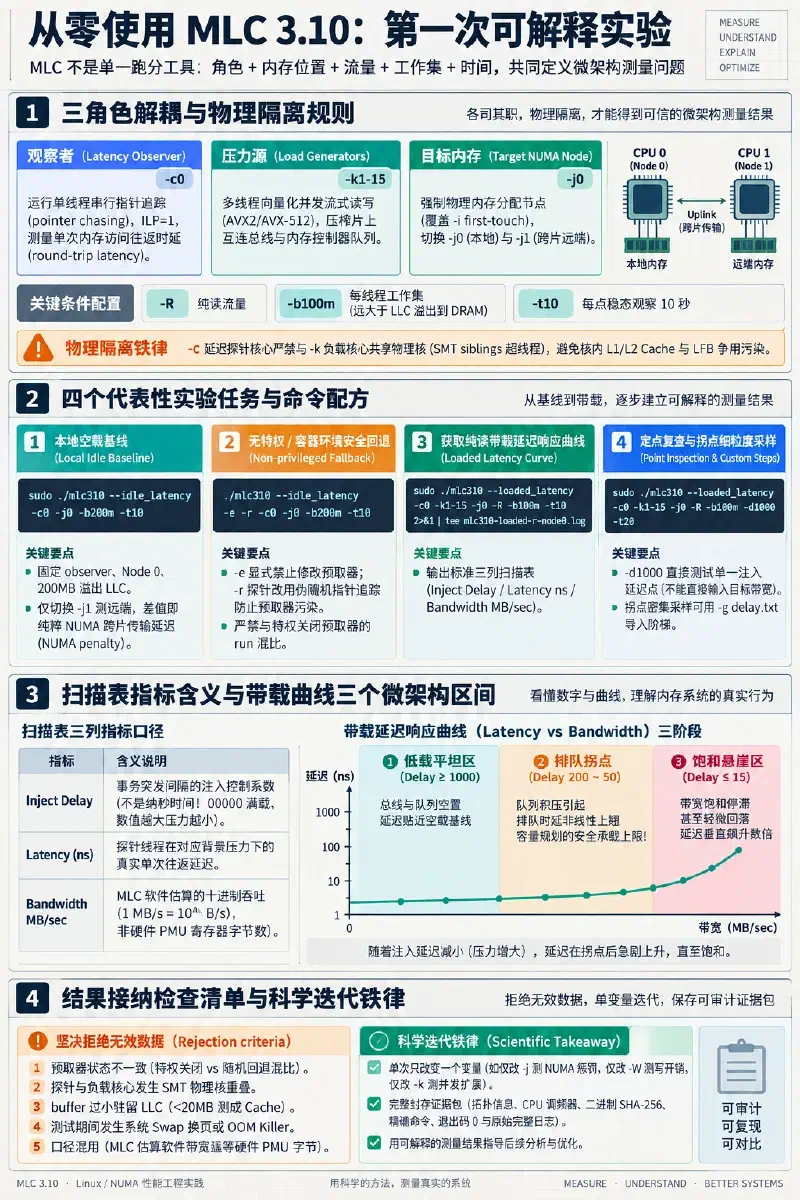
-t10如果只记住一个核心结论,请记住:MLC 不是输出单一“内存跑分”的 benchmark。它通过 CPU 角色分配、NUMA 拓扑路径、内存访问模式与注入强度共同定义一个具体的微架构测量问题。
要让这些参数变成可解释、可复现的结果,需要走完一个完整的实验闭环:在目标服务器上核对硬件拓扑与权限,选择互不干扰的 CPU 与 NUMA Node,分别测定空载基线与带载延迟曲线,正确读取拐点与饱和区,再把命令、系统状态和原始输出归档为可审计的证据包。
本文针对 Intel MLC 3.10。命令中的 CPU 核心号与 NUMA 编号为典型示例,执行前必须结合目标主机的实际拓扑进行适配。
1. 先把一次测量拆成三个角色#
很多测试之所以无法解释,是因为把所有线程混在一起运行,分不清测到的是内存控制器排队、总线拥塞,还是 CPU 本身的执行瓶颈。--loaded_latency 的设计核心是把参与者解耦为三个角色:
观察者:延迟测量探针(Latency Thread)#
由 -c 参数指定(例如 -c0 绑定到 logical CPU 0)。
该线程只运行一个高度串行的指针追踪(pointer chasing)循环:每个 64 字节 cache line 中存放着下一个访问目标的内存地址。CPU 的乱序执行引擎无法在当前 load 返回前计算出下一个 load 的地址,因此指令级并行度(ILP)被强制压制为 1。处理器总耗时除以访问请求数,得到的正是单次内存访问的真实往返延迟(round-trip latency)。
压力源:背景流量生成线程(Load-generation Threads)#
由 -k 参数指定(例如 -k1-15 绑定到 logical CPU 1 至 15)。
这些线程的行为与探针截然相反:它们使用向量化指令(如 AVX2 或 AVX-512)持续发出彼此独立的流式读写请求,不等待数据被后续计算消费,目的是制造尽可能高的并发内存请求,将片上互连网络(interconnect)、队列缓冲以及内存控制器的通道带宽压榨至饱和。
目标内存:物理归属位置(Target NUMA Node)#
由 -j 参数指定(例如 -j0 指定内存从 NUMA Node 0 分配)。
-j 参数会强制所有线程的目标 buffer 通过 NUMA API 绑定在指定节点上,并覆盖 -i(CPU first-touch)策略。如果探针 CPU 位于 Socket 0,目标内存也位于 Node 0,测得的是本地访问(Local Node);若将 -j 切换为 Node 1,则所有探针与流量请求都必须穿越跨片互连总线(如 Intel UPI 或 AMD Infinity Fabric),测得的是远端访问(Remote Node)。
角色隔离的物理规则#
在配置角色时,必须注意以下微架构限制:
- 避免 SMT 物理核共用:
-c指定的延迟线程绝对不能与任何-k负载线程共享同一个物理核心(SMT siblings / 超线程)。超线程共享核心内的 L1/L2 Cache、Line Fill Buffer(LFB)以及执行单元,如果负载线程在同一物理核上狂发请求,探针记录到的延迟将混入大量核内核外争用干扰,无法反映内存系统的真实行为。 - 带宽统计口径:MLC 输出的
Bandwidth是由工具自身统计的内存事务估算出来的软件吞吐(包含延迟线程和所有负载线程的总流量),以十进制MB/sec(\(1\text{ MB/s} = 1{,}000{,}000\text{ Bytes/s}\))汇报,不是硬件 PMU 或内存控制器物理寄存器的直接读数。
2. 运行前固定拓扑、二进制与环境条件#
在敲下测试命令前,必须先摸清宿主机拓扑并固化环境状态。
拓扑探测#
运行以下命令记录 logical CPU、物理核、Socket 与 NUMA 节点的映射关系:
lscpu
lscpu -e=CPU,NODE,SOCKET,CORE,ONLINE
numactl --hardware
输出中的 CORE 列代表物理核编号。例如若 CPU 0 与 CPU 32 的 CORE 相同,说明它们是一对超线程兄弟;在配置 -c0 时,-k 的列表中就必须剔除 CPU 0 与 CPU 32。同时检查 numactl --hardware 确认各 Node 的内存大小,防止把目标内存指定到无内存节点(memoryless node)或空闲内存不足的节点上。
二进制与版本核对#
核对 MLC 可执行文件的架构、依赖与哈希:
file ./mlc310
ldd ./mlc310
sha256sum ./mlc310
本文核对的本地二进制为 64 位 x86-64 动态链接 ELF 程序,自报版本为 Intel MLC v3.10,SHA-256 值为:
cd7de7ff3f73928fb2a273c01dd6cb2dffdc2dd0a77d68f9310e52016d3d24dd特别注意:MLC 3.10 没有标准的 --help 成功退出码。执行 ./mlc310 --help 会打印 Invalid Argument:--help 与完整的参数用法列表,但最终以状态码 22(EINVAL)退出。不要在自动化探测脚本中将退出码 0 作为 --help 成功的判断标准。另一个常见陷阱是:参数 -h 不是帮助选项,而是请求分配 1 GiB HugePage。
CPU 调频策略(Scaling Governor)#
在空载延迟测量中,CPU 频率波动会直接放大时间测量误差。在有权限的主机上,建议在测试前将各 CPU 的调频策略固定为高性能模式:
# 检查当前调频器
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor

# 若支持且具备 root 权限,临时固定为 performance
sudo cpupower frequency-set -g performance || true
若无法修改调频器,必须在证据包中记录当前频率策略,并在相同环境设置下进行横向比较。
硬件预取器与权限边界#
在 Intel 架构上,CPU 内部包含 Streamer、Spatial 等多层硬件预取器(Hardware Prefetchers)。当指针追踪以固定 64 字节步长向前扫描时,预取器会迅速捕捉到访问规律,提前将数据读入 L2/L1 Cache,导致测得的时延直接跌入 Cache 级别,无法反映 DRAM 性能。
MLC 默认会尝试加载 msr 驱动并通过读取/写入 MSR 寄存器(如 MSR 0x1a4)临时关闭延迟探针所在核心的预取器:
# 特权方式:允许 MLC 管理预取器
sudo modprobe msr
sudo ./mlc310 --idle_latency -c0 -j0 -b200m -t5
若以非 root 用户执行,或运行在未开放 MSR 写入的虚拟机/容器中,MLC 会输出警告:
*** Unable to modify prefetchers (try executing 'modprobe msr')
*** So, enabling random access for latency measurements
该警告表明 MLC 无法关闭预取器,为了避免测出被预取污染的虚假延迟,程序自动切换成了伪随机访问模式(-r)。若需要在非特权环境下做严格可比的基线测试,应显式传入 -e(不修改预取器)与 -r(随机访问):
./mlc310 --idle_latency -e -r -c0 -j0 -b200m -t5HugePage 与内存预算计算#
MLC 支持通过 -L 请求 2 MiB HugePage,或通过 -h 请求 1 GiB HugePage。使用大页可以减少 TLB miss 对长跨度内存访问造成的时延抖动。
运行前检查系统的大页配置:
grep -E 'HugePages|Hugepagesize|Hugetlb' /proc/meminfo规划 -b(每线程 buffer)时,必须提前按负载模式计算总内存开销,防止进程触发 OOM Killer:
- 纯读模式(
-R):总内存 \(\approx K \times b + b_{\text{latency}}\)(其中 \(K\) 为负载线程数)。 - 常规读写混合(
-W2、-W3、-W5等):MLC 会为每个线程同时分配一个读 buffer 和一个独立的写 buffer,总内存需求翻倍:\(\approx 2 \times K \times b + b_{\text{latency}}\)。 - Stream Triad 类似模式(
-W10、-W11):每个线程需要两个读 buffer 和一个写 buffer,总内存需求变为三倍:\(\approx 3 \times K \times b + b_{\text{latency}}\)。
例如:15 个负载线程搭配 -W10 -b100m,仅负载线程就需要分配约 \(15 \times 300\text{ MiB} \approx 4.5\text{ GiB}\) 内存。必须确保 -j 所指向的 NUMA 节点具备充足的空闲物理内存。
3. 建立空载基线,再引入背景压力#
实验的第一步是测定最纯粹的空载物理延迟(Idle Latency),建立基准线。
测定本地节点空载延迟#
下面的命令测试 CPU 0 访问 NUMA Node 0 内存的空载时延:
sudo ./mlc310 --idle_latency \
  -c0 \
  -j0 \
  -b200m \
  -t10
为什么选用 -b200m?现代服务器的末级缓存(LLC / L3 Cache)普遍达到数十至上百兆字节。若使用较小的 buffer(如 20 MiB),整个测试集都能驻留在 LLC 中,测得的将是 L3 Cache 命中延迟,而非主存 DRAM 延迟。设置 200 MiB 确保工作集完全溢出 LLC。
输出结果将直接给出以纳秒(ns)为单位的单次访问平均时延。
测定跨节点(远端)空载延迟#
保持其他所有参数不变,仅将目标内存改为 Node 1:
sudo ./mlc310 --idle_latency \
  -c0 \
  -j1 \
  -b200m \
  -t10
将第二次结果与第一次相减,二者的差值即为该硬件架构下跨 Socket/Die 互连总线带来的纯粹传输时延(NUMA penalty)。这种“单一变量法”是排查 NUMA 性能问题的标准动作。
引入背景压力:第一次带载实验#
确认空载基线后,启动带有并发流量的 --loaded_latency 测试:
sudo ./mlc310 --loaded_latency \
  -c0 \
  -k1-15 \
  -j0 \
  -R \
  -b100m \
  -t10 \
  2>&1 | tee mlc310-loaded-r-node0.log
执行后,MLC 会自动在终端打印一张带载延迟扫描表:
Intel(R) Memory Latency Checker - v3.10
Command line parameters: --loaded_latency -c0 -k1-15 -j0 -R -b100m -t10

Using buffer size of 100.000MiB/thread for reads
Measuring Loaded Latencies for the system
Inject	Latency	Bandwidth
Delay	(ns)	MB/sec
==========================
 00000	348.86	 553559.9
 00002	346.39	 553423.0
 00008	349.51	 553354.2
 00015	345.54	 553504.1
 00050	341.89	 553243.6
 00100	172.77	 550627.5
 00200	132.19	 410770.0
 00300	126.36	 288965.7
 00400	124.53	 222943.8
 00500	124.05	 181608.8
 00700	120.98	 132578.6
 01000	120.51	  94452.8
 01300	114.86	  73423.7
 01700	113.66	  56664.6
 02500	111.73	  38988.9
 03500	112.28	  28115.2
 05000	110.86	  19912.8
 09000	110.58	  11356.1
 20000	111.73	   5434.1
这张表的三列具有严格且不可混淆的物理含义:
Inject Delay:负载线程在每次事务突发(transaction burst)之间的注入延迟周期。该数值不是纳秒时间,而是注入节流控制系数。00000表示不节流、全力满载注入;数值越大,背景流量压力越低。Latency (ns):当前注入级别下,探针线程(CPU 0)访问目标内存测得的平均往返物理时延,单位为纳秒。Bandwidth MB/sec:当前注入级别下,系统达到的总内存访问带宽估算,单位为十进制 \(\text{MB/s}\)。
4. 解读带载延迟曲线与关键拐点#
把上述扫描表绘制成以 Bandwidth 为横轴、Latency 为纵轴的散点折线图,就能得到内存子系统经典的带载延迟响应曲线。该曲线在工程上呈现三个明显的微架构工作区间:
1. 低载平坦区(Low-utilization Region,大 Delay 区间)#
对应 Delay >= 01000 甚至更大值。
在此区间内,总线利用率低,内存控制器内部的请求队列、命令调度队列以及重排序缓冲区大多处于近乎空置状态。探针发出的请求到达内存控制器后几乎无需排队即可立即下发给 DRAM 颗粒。因此,此时测得的带载时延与第 3 节测得的空载时延基本吻合,曲线表现为一条接近水平的基线。
2. 排队延迟拐点(Knee Point / Congestion Onset)#
对应表中 Delay 在 00200 至 00050 附近的区域。
随着背景注入流量持续升高,内存控制器内部队列开始积压,总线仲裁等待时间显著上升。根据排队论经典规律(如 \(M/M/1\) 队列),当服务设施利用率逐渐接近瓶颈时,平均排队时间呈现非线性放大:
$$W_q \approx \frac{\rho}{\mu(1 - \rho)}$$曲线在此处开始发生肉眼可见的明显上翘。在生产系统容量规划中,拐点对应的吞吐量才是具有实用价值的“安全最大承载带宽”。一旦业务系统的实际内存流量越过拐点,延迟对流量微小波动的敏感度将急剧上升。
3. 饱和悬崖区(Saturation Region,Delay 接近 00000)#
对应 Delay <= 00015 的极限工况。
在此区间,DRAM 总线与控制器调度器已处于绝对饱和状态。即使负载线程继续以最强力度拼命注入,总带宽也几乎不再增长(甚至可能因为读写通道频繁切换、行缓冲冲突或总线仲裁开销过大而发生轻微回落),但延迟却垂直攀升数倍。单看峰值带宽可能会误以为系统吞吐可观,但此时任何落在该节点的延迟敏感型业务都将遭受严重的排队停顿。
定点复查与细粒度采样#
如果只需要重现或复查曲线上的某一个特定工作点,可以直接传入 -d:
# 只测 Delay=1000 的工作点,观察 20 秒
sudo ./mlc310 --loaded_latency \
  -c0 -k1-15 -j0 \
  -R -b100m -d1000 -t20
MLC 默认的 delay 列表在拐点附近跳跃较大。如果希望在排队拐点区域(例如 50 到 500 之间)进行高密度采样以精确定位 knee point,可以准备一个自定义延迟文件 delay.txt:
0
10
25
50
75
100
150
200
300
500
1000
2000
5000
然后通过 -g 参数导入:
sudo ./mlc310 --loaded_latency \
  -c0 -k1-15 -j0 \
  -R -b100m -gdelay.txt -t10
若本次实验的任务仅仅是测量系统的极限吞吐,不需要探针线程,可以传入 -T 启用吞吐专用模式:
sudo ./mlc310 --loaded_latency -T -k0-15 -j0 -R -b100m -d0 -t20在 -T 模式下,探针线程被彻底禁用,CPU 0 也可以作为压力源加入 -k 列表中。但必须明确:带探针的实验与 -T 纯吞吐实验属于不同的线程配置,不可直接混比。
5. 参数改变的是测量问题,而非只是数字#
修改 MLC 命令中的任何一个参数,改变的都是底层的物理交互路径。下表梳理最核心的参数控制对象与误用后果:
| 参数 | 控制对象 | 物理行为与误用后果 |
|---|---|---|
-c | 延迟探针 CPU | 决定指针追踪的发起点;若与 -k 共享物理核会导致严重的 SMT 资源污染 |
-k | 负载生成 CPU 列表 | 决定并发压力源的规模与物理拓扑分布;改变核心数即改变注入并发度 |
-j | 目标 NUMA Node | 强制指定内存分配节点(覆盖 -i);改动此项将切换本地访问与跨片远端访问路径 |
-R / -Wn | 流量读写特征 | -R 为纯读;-Wn 引入写流量,决定是否触发 Cache RFO 与写回总线开销 |
-b | 每线程工作集大小 | 过小会导致测试数据驻留 Cache;混合读写模式下会成倍申请内存,易触发 OOM |
-U | 负载线程随机访问 | 默认负载为顺序流式;开启 -U 会打乱负载地址,大幅降低行缓冲命中率 |
-t / -d / -g | 采样时长与注入点 | -t 决定稳态观察时间;-d/-g 决定曲线在横轴上的采样分布与分辨率 |
读写流量模式深度剖析(-W 系列)#
除了纯读(-R),MLC 支持多种读写混合模式,其中最关键的区别在于普通缓存写入(Cached Store)与非临时写入(Non-Temporal Store):
- 普通写入(如
-W22:1 读写、-W51:1 读写):CPU 执行普通 store 指令。若待写入地址不在当前 Cache,硬件会首先向内存发起所有权读取请求(Read For Ownership, RFO),把整行读入 Cache,再在 Cache 中修改;待后续淘汰时再写回内存。因此,在总线上通常会产生“先读后写”的双重流量。 - 非临时写入(NT Write,如
-W6纯写、-W72:1 读写、-W81:1 读写):使用非临时指令(如MOVNTI或VMOVNTDQ)直接绕过 L1/L2/L3 Cache,写入 Write Combining 缓冲并直达内存总线,不产生 RFO 读流量。 - 多流 Stream Triad 模式(
-W10、-W11):模拟经典 Stream Triad(\(A[i] = B[i] + q \times C[i]\))的访问特征。例如-W10虽然同为 2:1 读写(NT write),但它的两次读操作分别来自于两个互不重叠的独立内存 buffer,访问流交错程度更高,总线调度行为与单一 buffer 的-W7存在显著差异。
6. 构建可审计、可复核的实验证据包#
一张包含数字的终端截图无法证明一次实验的有效性。一个规范的 MLC 实验证据包必须完整封存系统拓扑、环境特征、二进制指纹、输入参数与原始执行日志。
建议编写一个标准的执行归档脚本 run-mlc.sh,通过脚本以批处理方式启动测试并自动打包证据:
#!/usr/bin/env bash
set -euo pipefail

# 1. 创建带时间戳的独立证据目录
RUN_TIMESTAMP="$(date +%Y%m%d-%H%M%S)"
RUN_DIR="mlc-evidence-${RUN_TIMESTAMP}"
mkdir -p "${RUN_DIR}"

echo "=== Collecting Pre-flight Environment ==="
# 2. 收集系统拓扑与内存大页状态
lscpu > "${RUN_DIR}/lscpu.txt"
lscpu -e=CPU,NODE,SOCKET,CORE,ONLINE > "${RUN_DIR}/lscpu-topology.txt"
numactl --hardware > "${RUN_DIR}/numactl-hardware.txt"
grep -E 'HugePages|Hugepagesize|Hugetlb' /proc/meminfo > "${RUN_DIR}/meminfo-hugepages.txt"

# 3. 收集 CPU 调频器状态
if [ -f /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor ]; then
  cat /sys/devices/system/cpu/cpu*/cpufreq/scaling_governor > "${RUN_DIR}/scaling-governor.txt"
fi

# 4. 固化二进制指纹
sha256sum ./mlc310 > "${RUN_DIR}/mlc310.sha256"

# 5. 记录执行意图与结构化元数据
cat << 'EOF' > "${RUN_DIR}/experiment-meta.yaml"
experiment:
  title: "Node 0 Local Read Loaded Latency Baseline"
  binary: "mlc310"
  expected_sha256: "cd7de7ff3f73928fb2a273c01dd6cb2dffdc2dd0a77d68f9310e52016d3d24dd"
  roles:
    latency_cpu: 0
    load_cpus: "1-15"
    target_node: 0
  workload:
    traffic_type: "R"
    buffer_per_thread: "100m"
    duration_per_point_s: 10
  prefetcher_policy: "hardware-disabled-or-random-fallback"
EOF

# 6. 保存精确执行命令
TARGET_CMD="./mlc310 --loaded_latency -c0 -k1-15 -j0 -R -b100m -t10"
printf '%s\n' "${TARGET_CMD}" > "${RUN_DIR}/command.txt"

echo "=== Executing MLC Measurement ==="
# 7. 执行测量并完整保存 stdout 与 stderr
set +e
${TARGET_CMD} 2>&1 | tee "${RUN_DIR}/raw-mlc-output.log"
EXIT_CODE="${PIPESTATUS[0]}"
set -e

printf '%d\n' "${EXIT_CODE}" > "${RUN_DIR}/exit-code.txt"
echo "=== Run finished with exit code ${EXIT_CODE} ==="
exit "${EXIT_CODE}"
执行后,该目录中将包含复现与审查该次实验所需的全部原始输入与上下文,避免日后产生“当时到底用的是哪个核心、关没关预取器、有没有大页”的悬案。
7. 实验结果的接纳、拒绝与科学比较#
收集到日志后,绝不能看到输出了表格就直接采纳。必须按照以下清单逐一审查:
结果接纳清单#
- 退出状态核对:
exit-code.txt必须严格为 0。 - 日志完整性:扫描表从最小 Delay 到最大 Delay 是否完整输出,未发生非预期的提前中断。
- 预取器状态已知:明确知晓本次实验是成功关闭了硬件预取器,还是回退到了
-r随机访问模式。 - 核心未发生 SMT 重叠:已核实探针核心与负载核心物理独立。
- 内存无外溢与置换:系统未触发 OOM Killer,
free -m或/proc/vmstat显示测试期间未发生系统 swap 换页。 - 工作集落在 DRAM:设置的 buffer 大小经确认已远远超越物理 LLC 容量。
必须坚决拒绝结果的场景#
出现以下任何情况时,该次测量结果均属于无效数据,必须拒绝并重新组织实验:
- 预取器策略不一致却进行横向混比:一组数据在 root 下关闭了预取器,另一组在非 root 下自动回退到了随机访问,却把两者的延迟数值放在同一张图上对比。
- 核心拓扑混淆:把逻辑超线程当作独立物理核分配给了负载线程,且与探针核心挤在同一个物理核内。
- 工作集截留在 Cache:设置了过小的 buffer(如 10 MiB),测出 15 ns 的超低“内存延迟”,实际测量的只是 L3 Cache。
- 系统发生内存置换:测试期间触发了 Linux swap 或跨节点内存借用,导致延迟出现毫无规律的毫秒级尖刺。
- 口径混用:把 MLC 自行估算的软件 MB/s 带宽,直接与总线 PMU 硬件计数器统计的 DRAM 物理通道字节数强行画等号。
科学迭代原则:单次只变动一个变量#
在完成一次合格的基线实验后,后续的所有探索都必须遵循严格的受控变量法:
- 若想研究 NUMA 跨片惩罚,仅将
-j0改为-j1,保持-c、-k、-R、-b完全一致; - 若想研究 写穿透与总线翻转开销,仅将
-R改为-W7或-W2,其余参数完全固定; - 若想研究 并发扩展性,仅逐步增加
-k中的负载核心数,其余条件保持一致。
只有每次运行都留下完整的证据归档,这种变量对比得出的性能结论才经得起推敲与复核。若需查询 MLC 3.10 的全量命令行开关、各模式参数适用矩阵、大页配置脚本及常见故障排查,可进一步查阅本系列配套的参数速查参考。
本文采用 CC BY-NC-SA 4.0 许可。