阅读信息
- 内容类型:参考
- 难度:中级
- 适合谁:准备在 Linux NUMA 服务器上使用 MLC 3.10 的性能工程师
- 前置知识:Linux 命令行、CPU 与 NUMA 的基本概念
- 读完后:按症状或参数快速找到 MLC 3.10 的精确定义、适用范围和恢复动作。
- 依据版本:Intel MLC v3.10; local binary SHA-256 cd7de7ff3f73928fb2a273c01dd6cb2dffdc2dd0a77d68f9310e52016d3d24dd
- 验证日期:2026-08-23
本页作为 Intel MLC 3.10 的工程查阅手册,不承担渐进式概念教学。文档中所有命令行语法、参数开关、退出码特征与微架构行为,均基于 Intel 官方技术文档及本地验证二进制(SHA-256: cd7de7ff3f73928fb2a273c01dd6cb2dffdc2dd0a77d68f9310e52016d3d24dd)严格对齐。
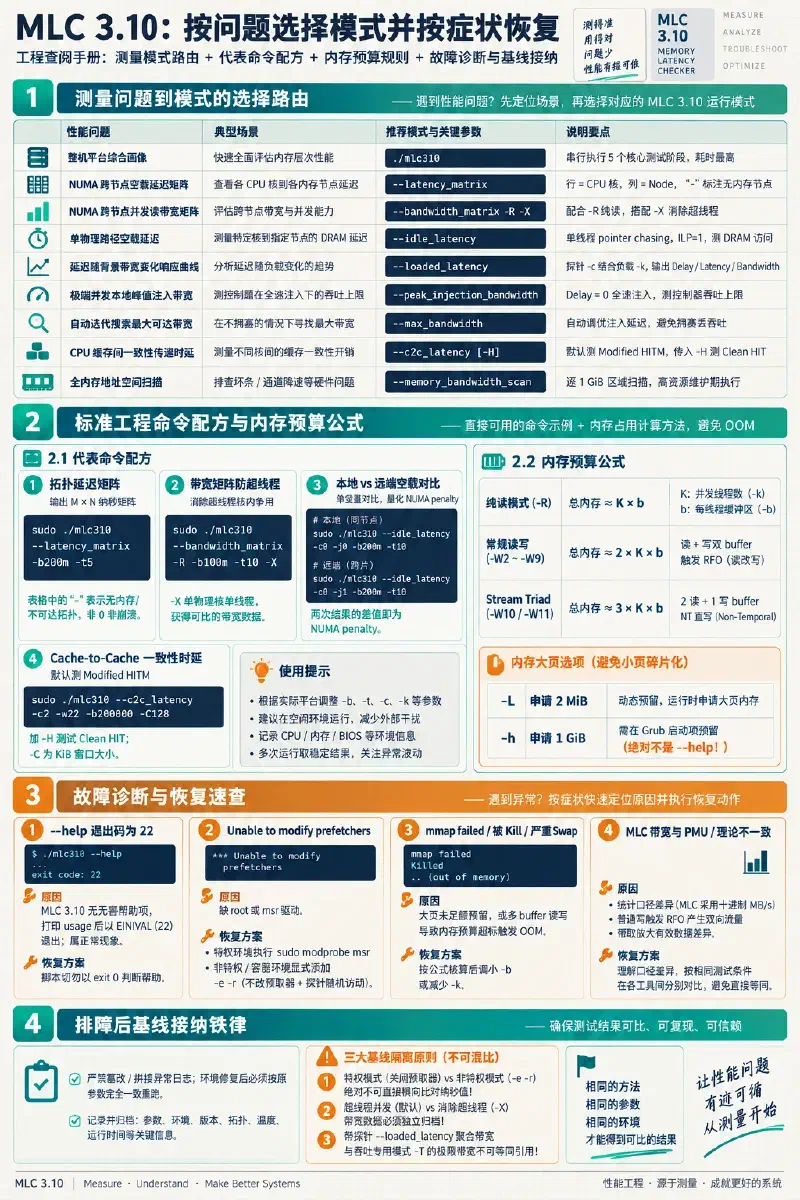
1. 测量模式总览#
MLC 3.10 包含 8 种专门测量模式以及一个默认复合模式。不同的模式对应不同的微架构问题与输出格式:
| 模式开关 | 测量目标 | 核心输出指标 | 默认行为与说明 |
|---|---|---|---|
(无参数) ./mlc310 | 平台综合画像 | 延迟矩阵、峰值注入带宽、带宽矩阵、带载延迟、C2C 延迟 | 依次串行执行 5 个核心测试阶段;总耗时与资源消耗最高 |
--latency_matrix | NUMA 跨节点空载延迟矩阵 | 各 Socket/Core 到各 NUMA 节点的单跳时延(ns) | 默认以物理核 0 探测,输出 \(M \times N\) 矩阵,不可达/无内存节点标注为 - |
--bandwidth_matrix | NUMA 跨节点并发带宽矩阵 | 各 Socket 到各 NUMA 节点的读写吞吐(MB/s) | 默认采用纯读流式流量(-R),测试节点间互连总线互通带宽 |
--peak_injection_bandwidth | 平台本地峰值注入带宽 | 纯读、3:1、2:1、1:1 及 Stream-triad 模式的吞吐(MB/s) | 以零延迟(Delay=0)全速注入,反映内存控制器在极端并发下的吞吐上限 |
--max_bandwidth | 平台最大可达带宽搜索 | 自动迭代不同注入延迟后的最大吞吐(MB/s) | 自动调优注入延迟;某些平台上因为拥塞消除,小非零延迟带宽可能高于零延迟 |
--idle_latency | 单核指定路径空载物理时延 | 单次指针追踪平均时延(ns),可选时延直方图 | 默认由 CPU 0 访问 Node 0,单线程 pointer chasing,压制指令级并行(ILP=1) |
--loaded_latency | 带载延迟响应曲线 | 注入延迟(Delay)、探针时延(ns)、聚合带宽(MB/s) | 支持自动扫频或自定义 delay 列表,输出内存子系统排队与拥塞特征 |
--c2c_latency | CPU 缓存间一致性传递时延 | 本地/跨片 L2 到 L2 HIT 与 HITM 时延(ns) | 测量写核心(Writer)将 Cache line 置为 Modified 或 Clean 后,读核心(Reader)命中该行的时间 |
--memory_bandwidth_scan | 全内存地址空间扫描 | 每个 1 GiB 物理区域的读带宽(MB/s)与直方图分布 | 仅限 Linux;高资源长时间操作,用于排查通道间交错不均或物理内存降速故障 |
2. 命令行参数全集与模式兼容性#
并非所有参数都能跨模式混用。下表整理了 MLC 3.10 的全部参数定义、取值约束及所适用的测试模式:
| 参数 | 参数类型 | 默认值 | 适用模式 | 功能定义与微架构影响 |
|---|---|---|---|---|
-a | 无参数 | 关闭 | latency_matrix, idle_latency | 在所有可用 CPU 上测量延迟;若同时指定 -X,则每个物理核只取一个 SMT 线程 |
-b<size> | 整数/带单位 | 100000 (KiB) | 全模式支持 | 设置每个 CPU/线程的 buffer 大小,支持 k/m/g 后缀(如 -b200m);读写混合时按倍数分配 |
-B | 无参数 | 关闭 | loaded_latency | 在输出中额外打印每个负载线程的独立吞吐量(per-thread throughput) |
-c<n> | 整数 | 0 | idle_latency, loaded_latency, c2c_latency | 将延迟探针(Reader)线程绑定到 logical CPU #n;在 c2c 测试中表示 Reader CPU |
-C<size> | 整数 (KiB) | 2000 | c2c_latency | 设置 Cache-to-Cache 数据传输窗口大小,单位为 KiB |
-d<n> | 整数 | 0 | loaded_latency | 设置负载线程在事务突发之间的注入延迟周期;指定后直接测定单一工作点,跳过全量扫频 |
-D<n> | 整数 | 4096 | latency_matrix, idle_latency, loaded_latency, c2c_latency | 设置探针随机访问窗口跨度,单位为 Cache line 数(每行 64 字节) |
-e | 无参数 | 关闭 | 全模式支持 | 显式禁止修改 CPU 硬件预取器 MSR;在非 root 或虚拟化环境中必须开启 |
-E<size> | 整数 (KiB) | 0 | c2c_latency | Writer 线程额外读取的 Cache line 范围,用于将目标数据行挤出高层 Cache,推向更低层 |
-f<n> | 整数 | 关闭 | idle_latency | 启用时延分布直方图统计,每个桶(bucket)宽度为 \(2^n\) 个 CPU 基频周期(base cycles) |
-g<file> | 文件路径 | 无 | loaded_latency | 指定包含自定义注入延迟数值的文本文件,每行一个数值,替代默认扫频阶梯 |
-G<size> | 整数 (KiB) | 0 | c2c_latency | Reader 线程在 c2c 测试中额外读取的 buffer 大小,单位为 KiB |
-h | 无参数 | 关闭 | 除 memory_bandwidth_scan 外 | 请求使用 1 GiB HugePage(Linux 依赖 hugetlbfs 1G 预留;Windows 仅限 DAX 映射)。不是 help! |
-H | 无参数 | 关闭 | c2c_latency | 测试 Clean 状态 Cache line 的共享命中传递时延(HIT);默认测试 Modified 状态(HITM) |
-i<n> | 整数 | 无 | idle_latency, loaded_latency, c2c_latency | 由 logical CPU #n 初始化并首访内存(first-touch 决定物理节点);可被 -j 覆盖 |
-I | 无参数 | 关闭 | loaded_latency | 对读入数据执行 XOR 校验和数据完整性校验;仅在纯读(-R)负载下有效 |
-j<n> | 整数 | 无 | idle_latency, loaded_latency, memory_bandwidth_scan | 强制从 NUMA Node #n 分配物理内存;优先于 -i,与 -J 互斥 |
-J<dir> | 目录路径 | 无 | idle_latency | 在指定目录创建持久内存(PMEM)mmap 文件;与 -j 互斥 |
-k<list> | 核心列表 | 全部可用核心 | loaded_latency, peak_injection_bandwidth, max_bandwidth | 负载生成线程绑定的 logical CPU 列表,支持连字符与逗号(如 1-7,16-23);需排除探针核心 |
-K<n> | 整数 | 关闭 | loaded_latency | 控制对 64 字节 Cache line 的非完整读写粒度(例如 16 字节或 32 字节 partial access) |
-l<size> | 整数 (Bytes) | 64 | 全模式支持 | 内存遍历的步长(stride length),单位为字节;默认 64 字节即一条 Cache line |
-L | 无参数 | 关闭 | 除 memory_bandwidth_scan 外 | 请求使用 2 MiB Large Page(Linux hugetlbfs);需系统提前预留足够的 2M 大页 |
-m<hex> | 十六进制掩码 | 无 | loaded_latency, peak_injection_bandwidth, max_bandwidth | 以十六进制掩码指定负载 CPU(如 -m0xfffe);推荐改用语法更直观的 -k |
-M<file> | 文件路径 | 无 | 多种带宽模式 | 用特定十六进制模式文件初始化内存,每行 128 个十六进制字符(64 字节),最多 256 行 |
-n<n> | 整数 | 无 | loaded_latency, memory_bandwidth_scan | 配合 -U 设置负载随机访问跨度;在 memory_bandwidth_scan 中表示执行 CPU 所在的 NUMA 节点号 |
-o<file> | 文件路径 | 无 | loaded_latency | 高级配置文件,为每个线程独立设置分配大小、读写比例、访问模式及目标节点 |
-p<list> | 核心列表 | 无 | idle_latency | 在指定的各 Socket 核心上启动 dummy 线程,防止 CPU 封装进入深度节能休眠状态 |
-P | 无参数 | 关闭 | loaded_latency | 持久内存(PMEM)写入后执行 CLFLUSHOPT 指令强刷;文档要求配合 -Z 使用 |
-q<n> | 整数 | 10 | memory_bandwidth_scan | 对每个 1 GiB 内存区域测量的迭代次数 |
-Q | 无参数 | 关闭 | loaded_latency | 对任意内存写入后执行 CLFLUSHOPT 指令强制刷入 DRAM;文档要求配合 -Z 使用 |
-r | 无参数 | 关闭 | latency_matrix, idle_latency, loaded_latency, c2c_latency | 探针线程改用伪随机地址指针追踪;在无法通过 MSR 关闭硬件预取器时必须配合使用 |
-R | 无参数 | 开启 (部分模式) | loaded_latency, bandwidth_matrix | 负载线程采用 100% 纯读流量模式;不能与 -W 同时指定 |
-S<n> | 整数 | 5000 | c2c_latency, memory_bandwidth_scan | 在 c2c 中指定参与转发的第三个 CPU;在 memory scan 中表示直方图桶宽(MB/s) |
-t<n> | 整数 (秒) | 2 | 全模式支持 | 每个测量点或扫频阶梯的稳态观察秒数;在 memory scan 中被复用为并发访问线程数 |
-T | 无参数 | 关闭 | loaded_latency | 吞吐专用模式(Throughput-only);不启动探针线程,核心 0 也可加入负载列表 -k |
-u | 无参数 | 关闭 | loaded_latency | 所有负载线程共享同一个内存 buffer;用于评估非包含式 L3 Cache(Non-inclusive LLC)纯读带宽 |
-U | 无参数 | 关闭 (顺序流) | loaded_latency | 负载生成线程采用随机访问模式;可配合 -n 控制随机范围 |
-v | 无参数 | 关闭 | 全模式支持 | 打印详细调试与中间计算信息(Verbose printout) |
-w<n> | 整数 | 无 | c2c_latency | 将 c2c 测试中的 Writer 线程绑定到 logical CPU #n |
-W<n> | 模式标识 | 无 | 读写相关模式 | 指定负载线程的读写混合模式与指令类型(详见下节 -W 参数明细表) |
-x<n> | 整数 | 关闭 | latency_matrix, idle_latency, c2c_latency | 以循环迭代次数控制运行(单位:百万次);不能与 -t 混用;-x0 专用于遍历单次 buffer |
-X | 无参数 | 关闭 | 全模式支持 | 每个物理核心只使用一个 SMT 线程(关闭超线程并发);在高核数机器上常用于消除超线程核内争用 |
-Y | 无参数 | 关闭 (默认 SSE/AVX) | 带宽相关模式 | 强制负载线程使用 AVX2 256 位(32 字节)向量指令生成访存流量 |
-Z | 无参数 | 关闭 | 带宽相关模式 | 强制负载线程使用 AVX-512 512 位(64 字节)向量指令生成访存流量 |
-W 流量模式全集与微架构行为#
参数 -W 控制背景负载的读写比例与指令语义。不同取值直接决定了是否产生 Cache 行冲突与 RFO 流量:
-W 取值 | 读写比例 | 写入指令类型 | 内存分配与访问流特征 |
|---|---|---|---|
-W2 | 2:1 | 普通 Cached Store | 每线程分配 1 读 buffer + 1 写 buffer;写未命中时触发 RFO 读总线流量 |
-W3 | 3:1 | 普通 Cached Store | 同上,读流量占比提升至 75% |
-W4 | 3:2 | 普通 Cached Store | 同上,读写比例为 60% 读、40% 写 |
-W5 | 1:1 | 普通 Cached Store | 同上,读写各占 50% |
-W6 | 0:1 (纯写) | 非临时写入 (NT Store) | 100% 纯写流量;使用 MOVNTI/VMOVNTDQ 绕过 Cache 直写 DRAM,不触发 RFO |
-W7 | 2:1 | 非临时写入 (NT Store) | 66.7% 读 + 33.3% 直写 DRAM;单 buffer 混合流 |
-W8 | 1:1 | 非临时写入 (NT Store) | 50% 读 + 50% 直写 DRAM;单 buffer 混合流 |
-W9 | 3:1 | 非临时写入 (NT Store) | 75% 读 + 25% 直写 DRAM;单 buffer 混合流 |
-W10 | 2:1 | 非临时写入 (NT Store) | Stream Triad 类似模式:2 次读分别来自 2 个不同 buffer,1 次直写;每线程分配 3 个 buffer |
-W11 | 3:1 | 普通 Cached Store | 带 RFO 的 Stream Triad 类似模式:2 次读来自 2 个不同 buffer,1 次普通写;每线程分配 3 个 buffer |
-W12 | 4:1 | 普通 Cached Store | 80% 读 + 20% 普通 Cached Store |
-W21 | 100% 读 | 仅限 -o 配置文件 | 双地址流(2 address streams)纯读;不能在命令行直接指定 |
-W23 | 3:1 | 仅限 -o 配置文件 | 双地址流 3:1 读写;不能在命令行直接指定 |
-W27 | 2:1 | 仅限 -o 配置文件 | 双地址流 2:1 读 + NT 写;不能在命令行直接指定 |
高级配置文件格式(-o)#
当命令行无法满足复杂的非对称测试需求(例如某些线程做本地读,另一些线程做跨片 NT 写)时,使用 -o <filename> 为每个线程单独指定参数。该文件为纯文本格式,每行对应一个线程,由 6 个逗号分隔的字段构成:
thread_id, read/write ratio, random/seq, buffer size in KB, DDR4/pmem, remote node id字段约束:
thread_id:整数线程编号(从 0 开始递增)。read/write ratio:填写-W系列代号(如2、7、10、21、27或R)。random/seq:填seq(顺序访问)或rand(随机访问)。buffer size in KB:该线程占用的 buffer 大小(KB),例如102400。DDR4/pmem:填1(常规 DDR/DRAM 内存)或2(持久内存 PMEM)。remote node id:指定该线程的目标 NUMA 节点编号(如0或1)。
3. 标准工程命令配方#
以下命令均以生产排障与性能评测中的实际任务为目标编写:
配方 1:整机综合基线画像(全功能模式)#
# 自动依次执行空载矩阵、峰值带宽、带宽矩阵、带载延迟与 C2C 延迟
sudo ./mlc310 2>&1 | tee mlc-full-profile.log
配方 2:跨节点空载延迟拓扑矩阵#
# 探测所有 Socket 到各 NUMA 节点的单跳时延,每点观察 5 秒,使用 200MB 缓冲区确保溢出 LLC
sudo ./mlc310 --latency_matrix -b200m -t5
配方 3:跨节点纯读带宽拓扑矩阵(单核单线程)#
# 每个物理核只起 1 个线程以消除超线程干扰,测试各节点互通的最大读带宽
sudo ./mlc310 --bandwidth_matrix -R -b100m -t10 -X
配方 4:单核本地与远端空载延迟精确对比#
# 本地访问:CPU 0 -> Node 0
sudo ./mlc310 --idle_latency -c0 -j0 -b200m -t10

# 远端跨片访问:CPU 0 -> Node 1
sudo ./mlc310 --idle_latency -c0 -j1 -b200m -t10
配方 5:非特权 / 容器环境下的空载延迟测量#
# 在无 MSR 权限环境下,显式关闭预取器修改并开启伪随机探针以防预取器污染
./mlc310 --idle_latency -e -r -c0 -j0 -b200m -t10
配方 6:标准 2:1 读写(NT 直写)带载延迟扫描#
# 探针绑定 CPU 0,负载线程绑定 1-15,目标内存 Node 0,模式为 -W7(直写不占 Cache)
sudo ./mlc310 --loaded_latency \
  -c0 -k1-15 -j0 \
  -W7 -b100m -t10 \
  2>&1 | tee loaded-latency-w7.log
配方 7:系统极限读吞吐测量(Throughput-only)#
# 彻底停用探针,CPU 0-15 全力参与满负荷并发注入,寻找物理通道绝对峰值
sudo ./mlc310 --loaded_latency -T -k0-15 -j0 -R -b100m -d0 -t20
配方 8:探针空载时延分布直方图#
# 遍历一次 buffer(-x0),按 2^3=8 个基频周期的分辨率打印时延分布桶
sudo ./mlc310 --idle_latency -c0 -j0 -x0 -f3 -b200m
配方 9:跨物理核 L2-to-L2 Cache 一致性时延(HIT vs HITM)#
# 测量 Modified 状态 Cache line 的传递延迟(HITM,数据行需写回或嗅探转发)
sudo ./mlc310 --c2c_latency -c2 -w22 -b200000 -C128

# 测量 Clean 状态 Cache line 的共享读取传递延迟(HIT)
sudo ./mlc310 --c2c_latency -c2 -w22 -b200000 -C128 -H
配方 10:全物理内存地址空间一致性扫描#
# 扫描 Node 0 上的所有 1 GiB 物理区域,排查通道交错或个别内存条降速
# 注意:该操作会分配并占用目标 Node 的绝大部分可用内存,建议仅在维护期执行
sudo ./mlc310 --memory_bandwidth_scan -j0 -q10 -S5000
4. 内存开销公式与 HugePage 配置#
内存预算精准计算#
设置 -b 时必须根据工作模式计算物理内存消耗,防止触发 OOM Killer:
- 纯读模式(
-R):每线程分配 1 个 buffer。 $$\text{Memory}_{\text{load}} = N_{\text{load\_threads}} \times b$$ - 常规读写模式(
-W2至-W9):每线程分配 1 个读 buffer + 1 个写 buffer。 $$\text{Memory}_{\text{load}} = 2 \times N_{\text{load\_threads}} \times b$$ - 多流 Triad 模式(
-W10、-W11):每线程分配 2 个读 buffer + 1 个写 buffer。 $$\text{Memory}_{\text{load}} = 3 \times N_{\text{load\_threads}} \times b$$
若配置 -c0 -k1-15 -j0 -W10 -b100m,仅负载线程就要求 Node 0 必须具备至少 \(15 \times 3 \times 100\text{ MiB} = 4.5\text{ GiB}\) 连续物理内存。
HugePage 配置与核对#
使用大页可消除 TLB 抖动对微秒/纳秒级访存的影响。
# 1. 检查当前系统大页分配与剩余情况
grep -E 'HugePages_Total|HugePages_Free|Hugepagesize' /proc/meminfo

# 2. 动态预留 2048 个 2 MiB 大页(共 4 GiB)
sudo sysctl -w vm.nr_hugepages=2048

# 3. 若针对特定 NUMA 节点(如 Node 0)分配 2 MiB 大页
echo 2048 | sudo tee /sys/devices/system/node/node0/hugepages/hugepages-2048kB/nr_hugepages

# 4. 在 MLC 命令中启用 2 MiB 大页
sudo ./mlc310 --loaded_latency -c0 -k1-15 -j0 -R -b100m -L -t10
关于 1 GiB 大页(-h) 的特别说明:Linux 内核无法在运行长时间后可靠地通过内存碎片整理拼凑出连续的 1 GiB 物理页框。若要使用 -h,必须在系统启动引导项(Grub cmdline)中预先配置:
default_hugepagesz=1G hugepagesz=1G hugepages=8并在重启后通过 /proc/meminfo 确认 HugePages_Total 生效后再使用 -h 参数,否则进程会因内存映射失败直接退出。
5. 故障诊断与恢复速查#
在执行 MLC 过程中遇到非正常退出或异常指标时,按下表定位根因与恢复动作:
症状 1:执行 ./mlc310 --help 退出码为 22#
- 故障本质:MLC 3.10 没有标准的无害帮助选项。当传入无法识别的
--help字符串时,程序按照“参数解析失败”逻辑在终端打印用法手册,并调用exit(22)(即EINVAL,Invalid Argument)。 - 处置方案:这属于正常预期现象。在编写自动化运维或 CI 脚本时,切勿通过
exit 0判断帮助命令,应直接重定向捕获帮助输出或检查关键关键字。
症状 2:输出 *** Unable to modify prefetchers#
- 故障本质:程序尝试向
/dev/cpu/*/msr写入寄存器以关闭预取器,但当前进程缺乏 root 权限、缺少CAP_SYS_RAWIO能力,或者内核未加载msr模块。 - 自动伴生行为:MLC 会自动在下一行打印
*** So, enabling random access for latency measurements,并静默将探针切换为随机访问。 - 处置方案:
- 若具备特权:执行
sudo modprobe msr后,使用sudo重新运行; - 若在容器/无特权环境:显式加上
-e -r参数,明确声明使用“不关预取器 + 随机地址”的测试基准,并在测试日志中注明该限定条件。
- 若具备特权:执行
症状 3:进程启动即报 mmap failed 或内存分配错误#
- 故障本质:传入了
-L(2M 大页)或-h(1G 大页),但系统中未预留对应大页,或目标 NUMA Node 上的可用大页数量低于前述计算公式的总需求;或者系统处于低内存状态无法分配常规连续内存。 - 处置方案:
- 检查
cat /sys/devices/system/node/nodeN/hugepages/hugepages-2048kB/free_hugepages; - 若大页不足,提前向对应节点注入大页;若环境不支持大页,移除
-L或-h,退回普通 4KB 页面基线。
- 检查
症状 4:矩阵表格中出现大量连字符 -#
- 故障本质:表示该 Source 核心与 Destination 内存节点之间的链路无法完成测试,常见于:
- 目标节点属于无内存计算节点(Memoryless Node,
size 0 MB); - 源节点属于无 CPU 内存扩展节点(CPU-less Node);
- 指定的核心处于 offline 状态或受到 cgroup/cpuset 隔离限制。
- 目标节点属于无内存计算节点(Memoryless Node,
- 处置方案:执行
numactl --hardware与lscpu -e对照核对。连字符是拓扑物理限制的客观映射,不是数值为 0,更不是测试程序崩溃。
症状 5:测试进程突然被终止(Killed)或系统开始严重 Swap#
- 故障本质:每线程 buffer 设置过大(特别是在
-W2、-W10等多 buffer 场景下),导致总申请内存超出物理内存上限,触发 Linux 内核 OOM Killer 或引起全局换页颠簸(Page Throttling)。 - 处置方案:
- 查看
dmesg -T | grep -i oom确认是否触发了 OOM 杀进程; - 按照前述公式重新核算内存;调小
-b(如由-b200m降至-b100m)或减少并发线程列表-k。
- 查看
症状 6:命令行直接指定 -W21、-W23 或 -W27 报参数非法#
- 故障本质:这三个模式属于多地址流模式(multi address streams),MLC 内部解析器将其硬编码为仅在
-o配置文件中生效。 - 处置方案:编写
-o config.txt配置文件,在第二列写入21、23或27,然后通过./mlc310 --loaded_latency -o config.txt载入。
症状 7:MLC 报告带宽与硬件 PMU / 理论物理带宽存在显著差异#
- 故障本质:统计口径与总线微架构行为不一致引起的“假性偏差”:
- 单位差异:MLC 采用十进制 \(\text{MB/s}\)(\(1\text{ MB/s} = 10^6\text{ B/s}\)),而非二进制 \(\text{MiB/s}\)(\(2^{20}\text{ B/s}\));
- RFO 额外流量:使用
-W2/-W5等普通写模式时,硬件总线上实际产生了“读整行进缓存 + 写回”的双向流量,导致内存控制器 PMU 读数可能达到 MLC 软件报告带宽的近两倍;改用-W7/-W8等 NT 写模式可消除此差异; - 硬件预取放大:开启预取器时,总线上预读入但未被消费的数据会被 PMU 计入物理流量,而 MLC 只统计自身请求的有效数据;
- 工作集截留:若
-b过小导致数据驻留 L3 Cache,测得的将是缓存带宽而非 DRAM 物理通道带宽。
- 处置方案:明确业务需要评估的是“软件有效读写吞吐”还是“物理总线饱和吞吐”,在测试记录中严格标明测量口径。
6. 排障后的基线接纳与比较规则#
在定位并修复环境问题后,必须遵守以下接纳规则,才能确保前后数据的科学可比性:
- 严禁修饰或伪造日志:若前序测试因为 OOM 或权限问题中断,必须废弃该批次数据,不可通过修改日志片段把非完整输出拼接成“成功测试”。
- 固定受控运行环境:修复环境问题后重新运行,必须确保核心绑定(
-c、-k)、NUMA 目标(-j)、流量类型(-R/-W)、缓冲区大小(-b)与持续时间(-t)与此前计划完全一致。 - 基线隔离原则:
- 特权模式(MSR 成功关闭预取器)与非特权模式(
-e -r伪随机探针)属于两种不同的物理测试机制,绝对不可直接将纳秒时延数值进行算术对比; - 包含超线程并发(默认)与消除超线程(
-X)的带宽数据必须独立归档,不可混为一谈; - 带有探针的
--loaded_latency聚合带宽与吞吐专用模式-T的极限带宽,不可直接作为等价指标引用。
- 特权模式(MSR 成功关闭预取器)与非特权模式(
本文采用 CC BY-NC-SA 4.0 许可。