阅读信息
- 内容类型:解释
- 难度:入门
- 适合谁:初次接触内存性能测试的系统与性能工程师
- 前置知识:CPU、Cache 和主存的基础概念、时间与数据量的基本单位
- 读完后:从延迟与带宽心智模型出发,解释四个标准内核、逻辑字节、Best Rate 源码链路与 Validation。
- 依据版本:STREAM 5.10 canonical baseline
- 验证日期:2026-08-22
一次内存访问可能要等数十甚至上百纳秒,同一台机器却能持续搬运数十或数百 GB/s。前一个数字很“慢”,后一个数字又很“快”。如果它们都在描述内存,为什么不会互相矛盾?
因为它们度量的是两类不同的物理过程:单个请求发出到返回的等待时间,以及大量独立请求通过流水线并行服务后,单位时间内搬运的总数据量。理清这两个指标的差异,是准确理解 STREAM 基准测试、分析内存带宽与审查硬件性能数据的前提。
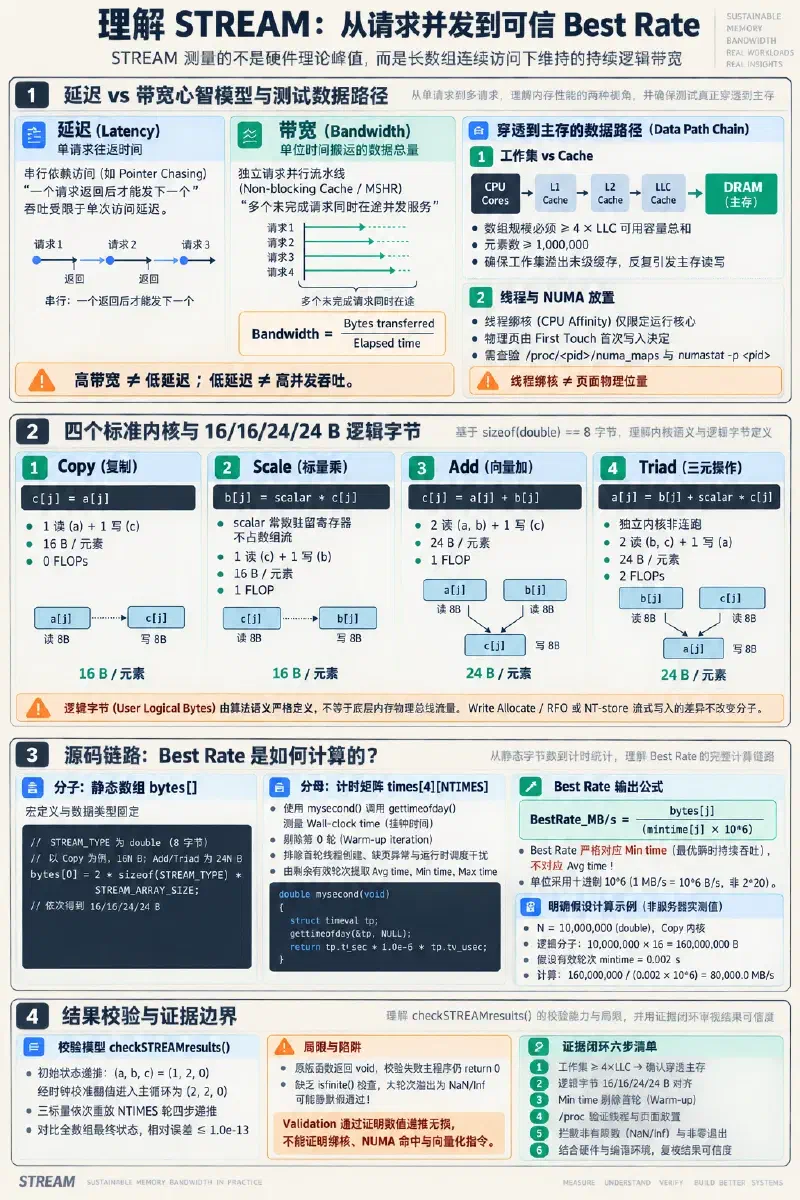
1. 延迟与并发:单个请求很慢,为什么一群请求仍然很快?#
延迟(Latency)从一个访问请求发出开始计时,直到目标数据到达处理器并可被后续指令使用。如果程序中的后一条访存指令依赖前一条指令读出的指针(例如链表遍历中的 pointer chasing),CPU 就无法提前发起下一次读取,所有请求只能串行等待:
请求 1 ───────── 等待 ─────────▶ 数据返回
                                 请求 2 才能发出 ───────── 等待 ─────────▶ 数据返回
这种模式下的吞吐完全受限于单次访问延迟。
带宽(Bandwidth)衡量的则是单位时间内系统实际搬运的数据量:
$$ \text{Bandwidth} = \frac{\text{Bytes transferred}}{\text{Elapsed time}} $$当内存控制器、总线和 CPU 内部的非阻塞缓存(Non-blocking Cache)与缺失状态保持寄存器(MSHR)允许多个未完成请求(In-flight requests)同时在途时,后一个请求无需等待前一个请求彻底返回即可流水线式发出:
请求 1 ───────────────────────────────▶ 数据返回
   请求 2 ───────────────────────────────▶ 数据返回
      请求 3 ───────────────────────────────▶ 数据返回
         请求 4 ───────────────────────────────▶ 数据返回
若把内存通道比作桥梁,单次延迟就像一辆车从桥头开到桥尾所需的时间,而带宽则是一分钟内通过桥梁的车辆总数。桥面上同时容纳的车越多,单位时间的吞吐就越大。高带宽并不缩减单个请求在总线上的固有传播时间,低延迟也无法直接保证系统在海量并发请求下具备高吞吐能力。
这也是为什么两种测试会报告截然不同的数字:指针追逐测试刻意制造地址依赖,测得的是内存访问的串行延迟;STREAM 则通过长数组的顺序连续循环,给硬件预取器和访存单元提供充沛的独立并发请求,测得的是持续流式带宽。
2. 带宽不是硬件标签:峰值、持续值与工作集#
硬件规格表上的“理论峰值带宽”通常由内存通道数、数据总线位宽和传输速率相乘计算得出:
$$ \text{Theoretical Peak} = \text{Channels} \times \text{Width (Bytes)} \times \text{Transfer Rate} $$例如 8 通道 DDR4-3200 内存的理论峰值为 \(8 \times 8\text{ B} \times 3200\text{ MT/s} = 204.8\text{ GB/s}\)。这是物理接口在完全理想条件下的数据搬运上限。
持续带宽(Sustained Bandwidth)则是特定程序在指定工作集、访问模式、指令组合、线程数量和系统噪声下实际维持的吞吐。STREAM 报告的是四个特定数组内核在长时循环下的持续逻辑带宽,而不是理论峰值,也不是全链路物理传输量。
要让 STREAM 测到真正的内存,数组大小至关重要:
- 若数组工作集小于末级缓存(LLC),数组在首轮循环被载入后便整体留在 Cache 中,后续读取和写入大部分被 Cache 吸收。此时程序测得的是末级缓存的数据吞吐,而非主存总线带宽。
- 官方 STREAM 5.10 的规则要求:每个数组的大小至少要是系统参与运行的核心可用末级缓存容量总和的 4 倍,且元素数不得少于 1,000,000。这样三个工作数组(
a、b、c)在循环迭代中必然产生反复的缓存行换出与主存读写,从而确保测试对象落在主存。
3. NUMA 拓扑与 First Touch:换一个核心为什么会变慢?#
在多插槽或多芯片架构中,处理器普遍采用非一致性内存访问(NUMA)架构。每个 NUMA Node 拥有物理直连的本地内存,访问本地 Node 延迟低、通道利用率高;跨 Node 访问远端内存则必须经过芯片互连总线,不仅延迟显著拉长,互连带宽也可能成为瓶颈。
Linux 内核对于普通的动态内存分配(如 malloc 分配的匿名页)通常实行首次触碰(First Touch)原则:页面在 malloc 调用时仅获得虚拟地址空间预留,直到某个 CPU 首次向该页面执行写入操作触发缺页异常时,内核才依据当前线程的 NUMA 内存策略将物理页分配给该 CPU 所在的本地 Node。
线程在哪个 CPU 上首次写入页面元素
               ↓
依据当时线程的 NUMA 内存分配策略(默认 local alloc)
               ↓
物理页实际分配到该 CPU 对应的本地 NUMA Node
               ↓
后续所有轮次访问:若工作线程留在该 Node 则为本地访问,若漂移到远端 Node 则为跨互连访问
如果数组初始化由单线程在 Node 0 上的 CPU 串行完成,整块内存的物理页就全部落在 Node 0。随后当多线程 OpenMP 循环并行运行时,运行在其他 Node 上的核心就必须全程跨互连访问 Node 0 的内存,造成严重的互连拥堵与性能急跌。
必须指出,First Touch 只是操作系统的内存分配机制,不能直接等同于“当前实验页面一定已正确分布”。线程绑核(Affinity)仅限定线程可在哪些 CPU 上运行,无法替你验证物理页最终落在哪一个 Node。要确认真实的物理页位置,必须在程序运行期间通过 /proc/<pid>/numa_maps 与 numastat -p <pid> 进行核对。
4. 审视性能数字时的五个核心问题#
看到一个声称达到数十或上百 GB/s 的内存性能数字时,应依次确认以下五个问题:
- 指标与单位:测试衡量的是单次等待延迟还是持续流式吞吐?单位采用十进制(\(10^6\text{ B/s} = 1\text{ MB/s}\))还是二进制(\(\text{MiB/s}\))?
- 数据路径层级:数组工作集相较参与运行核心的 LLC 总容量是多少?数据主要由 L1/L2/LLC 服务还是真正落入 DRAM?
- 并发与访问特征:运行使用了多少并发线程?内存访问是长距连续、跨步长还是指针离散跳变?
- 线程与内存放置:线程固定在哪些具体 CPU 核心?物理内存页实际分布在哪些 NUMA Node?
- 口径与有效性判定:吞吐的字节分子按什么规则计算?计时是否剔除预备轮?结果是否通过了数组数值校验?
5. 四个标准内核与 16/16/24/24 B 逻辑字节#
STREAM 并不通过读取硬件计数器来统计搬运的总字节,而是依据四个标准内核的代码语义定义了用户逻辑字节(User Logical Bytes)。
Copy 内核:一读一写#
Copy 的核心语句为:
c[j] = a[j];对于数组中的每一个下标 j,处理器必须从数组 a 中读取一个元素,并向数组 c 写入一个元素:
a[j] ── 读取 8 B ──▶ CPU 寄存器 ── 写入 8 B ──▶ c[j]在默认使用 8 字节双精度浮点数(sizeof(double) == 8)的前提下,每个元素的数据流包含 8 字节读取与 8 字节写入:
Scale 内核:标量乘法不增加数组流#
Scale 的核心语句为:
b[j] = scalar * c[j];scalar 是一个常数标量(STREAM 默认设置为 3.0)。它在进入主循环前已载入寄存器或本地缓存,不会在处理数组每个元素时都从主存重复读取一条独立的数组流。因此 Scale 的数组数据流依然是一条读取(c[j])和一条写入(b[j]),单元素逻辑字节同样为:
Add 与 Triad:两读一写的统一计数#
Add 的核心语句为:
c[j] = a[j] + b[j];从数组 a 读取 8 字节,从数组 b 读取 8 字节,将求和结果写入数组 c 的 8 字节,总计两读一写:
Triad(三元操作)的核心语句为:
a[j] = b[j] + scalar * c[j];其精确的数据流关系为:
b[j] ──────────────────────────┐
                               ├──── (+) ────▶ 写入 a[j] (8 B)
c[j] (8 B) ── (×) scalar ──────┘
与 Add 相同,Triad 同样是两条数组读流(读取 b 与 c)加上一条数组写流(写入 a),单元素逻辑字节同样为:
四个内核的逻辑字节与浮点运算汇总如下:
| 内核 | 表达式 | 数组数据流 | 逻辑字节/元素 | 浮点运算/元素 (FLOPs) |
|---|---|---|---|---|
| Copy | c[j] = a[j] | 读 a,写 c | 16 B | 0 |
| Scale | b[j] = scalar * c[j] | 读 c,写 b | 16 B | 1 |
| Add | c[j] = a[j] + b[j] | 读 a,读 b,写 c | 24 B | 1 |
| Triad | a[j] = b[j] + scalar * c[j] | 读 b,读 c,写 a | 24 B | 2 |
必须注意两个关键事实:
- Triad 是一个独立的内核循环,单次读取
b[j]和c[j],计算后写回a[j]。它绝不是把 Copy、Scale、Add 按顺序在内部连跑一遍。 - 逻辑字节不等于内存物理总线流量。由于现代 CPU 采用缓存行分配(Write Allocate)策略,普通写操作如果发生缓存未命中,往往需要先将目标缓存行从主存读入(Read-For-Ownership,RFO),再执行写入,从而产生额外的读流量;而使用流式写入(Non-temporal Store)指令时,则可能绕过缓存分配直接写入主存。无论硬件底层因缓存协议、硬件预取或写分配产生了多少真实物理字节,STREAM 报告的分子始终严格遵循统一的 16/16/24/24 字节逻辑定义。
6. 从源码反推:一行 Best Rate 是怎样计算出来的?#
运行官方 STREAM 程序后,终端会打印出类似下表的汇总:
Function    Best Rate MB/s  Avg time     Min time     Max time
Copy:           39278.1     0.210166     0.208564     0.213174
Scale:          ...         ...          ...          ...
Add:            ...         ...          ...          ...
Triad:          ...         ...          ...          ...
这一行中的五个数字全部由 main() 内部清晰的静态表与多轮计时数组推导得出。
分子:静态数组 bytes[]#
在 stream.c 中,四个内核每轮搬运的总逻辑字节在编译和初始化阶段就已由静态数组写死:
static double bytes[4] = {
    2 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE,
    2 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE,
    3 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE,
    3 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE
};
其中 STREAM_TYPE 默认为 double(8 字节),STREAM_ARRAY_SIZE 是宏定义的数组长度 \(N\)。四个项分别严格对应 Copy(\(16N\))、Scale(\(16N\))、Add(\(24N\))和 Triad(\(24N\))。这个数组是逻辑模型,绝不是运行时动态采集的硬件数据量。
分母:计时矩阵 times[4][NTIMES] 与 mysecond()#
程序通过外层循环迭代 NTIMES 轮(默认为 10 轮),每轮按顺序依次运行四个内核。以 Copy 为例:
times[0][k] = mysecond();
#pragma omp parallel for
for (j = 0; j < STREAM_ARRAY_SIZE; j++)
    c[j] = a[j];
times[0][k] = mysecond() - times[0][k];
mysecond() 调用 gettimeofday() 记录真实挂钟时间(Wall-clock time,秒数),而非进程占用的 CPU 周期数。因为 OpenMP 的 for 指令末尾存在隐式屏障(Barrier),结束时刻会在所有参与线程全部退出循环后才被记录。
为什么第 0 轮被彻底排除?#
所有 NTIMES 轮测试结束后,汇总统计并不是从下标 0 开始,而是从下标 1 循环到 \(NTIMES-1\):
for (k = 1; k < NTIMES; k++) {
    for (j = 0; j < 4; j++) {
        avgtime[j] = avgtime[j] + times[j][k];
        mintime[j] = MIN(mintime[j], times[j][k]);
        maxtime[j] = MAX(maxtime[j], times[j][k]);
    }
}
第 0 轮耗时同时被排除在 Avg time、Min time 和 Max time 之外。官方规范将其作为基准测试的预备轮(Warm-up iteration)。需要注意的是,不应轻率地将排除第 0 轮解释为“为了把数据预热到 Cache”——因为合法 STREAM 测试的工作集本就远大于末级缓存,无法在 Cache 中长久驻留;排除首轮更直接的目的是消除线程创建、运行时初始化、首次缺页与调度就绪等首轮非稳态干扰。
排除首轮后,程序由剩余的 \(NTIMES-1\) 轮耗时得出三个时间量:
Avg time:有效轮次的算术平均耗时 \(\frac{\sum_{k=1}^{NTIMES-1} \text{times}[j][k]}{NTIMES-1}\);Min time:有效轮次中的最短耗时 \(\min_{k=1..NTIMES-1} \text{times}[j][k]\);Max time:有效轮次中的最长耗时 \(\max_{k=1..NTIMES-1} \text{times}[j][k]\)。
Best Rate 的输出公式#
表格第二列的 Best Rate 计算公式为:
这揭示了三个至关重要的事实:
- Best Rate 仅使用 Min time 计算,代表系统在多轮测试中跑出的“最优瞬时持续吞吐”,它不是与 Avg time 对应的“平均带宽”;
- 单位换算采用十进制 \(10^6\),即 \(1\text{ MB/s} = 1{,}000{,}000\text{ B/s}\),而不是以 1024 为底的二进制进位;
- Avg 与 Max 的差距仅用于向分析人员提示测试过程中的系统抖动与异常轮次,它们不直接参与 Best Rate 的数值生成。
7. 初始状态、Validation 与校验局限#
状态递推:从 (1,2,0) 到 (2,2,0)#
在进入主测量循环前,STREAM 先对三个数组执行初始化:
for (j = 0; j < STREAM_ARRAY_SIZE; j++) {
    a[j] = 1.0;
    b[j] = 2.0;
    c[j] = 0.0;
}
随后,程序调用时钟校准函数 checktick(),并执行一段计时前校准循环:
for (j = 0; j < STREAM_ARRAY_SIZE; j++)
    a[j] = 2.0E0 * a[j];
数组 a 的元素值由 1.0 翻倍为 2.0。因此,当程序正式进入第 0 轮 Copy 内核时,三个数组的全局初始状态统一为:
checkSTREAMresults() 的标量重放模型#
测量完成后,校验函数 checkSTREAMresults() 并不会为每个元素单独计算复杂的数学逆变换,而是使用三个浮点标量 aj、bj、cj 严格重放整段生命周期:
aj = 1.0;
bj = 2.0;
cj = 0.0;
aj = 2.0E0 * aj;  /* 重现时钟校准阶段的倍增,状态变为 (2.0, 2.0, 0.0) */

scalar = 3.0;
for (k = 0; k < NTIMES; k++) {
    cj = aj;
    bj = scalar * cj;
    cj = aj + bj;
    aj = bj + scalar * cj;
}该标量重放模型能够成立,完全建立在每个数组元素在全部 NTIMES 轮中经历了完全相同的内核执行顺序与计算规则。重放结束后,校验器遍历整个数组计算实际值与期望标量之间的平均绝对误差:
$$ aAvgErr = \frac{\sum_{j=0}^{N-1} |a[j] - aj|}{N} $$若 \(\frac{aAvgErr}{aj} \le \epsilon\)(双精度下 \(\epsilon = 1.0 \times 10^{-13}\)),则判定数组通过校验并打印 Solution Validates。
官方 5.10 校验机制的工程局限#
在生产环境和自动化流水线中,不能盲目将原版 checkSTREAMresults() 的输出作为唯一的可靠防护:
- 函数返回
void,无非零退出码:当发生Failed Validation时,原版函数仅向标准输出打印错误文本,main()依然固定执行return 0。在自动化脚本中若仅检查 Shell 退出码($? == 0),会无条件放过数值错误的废弃运行。 - 缺乏显式有限数检查(NaN / Inf):若迭代轮数极大导致浮点递推溢出为
Inf,或者产生NaN,在 C 语言的浮点比较中,涉及NaN的关系运算(如NaN > epsilon)始终返回假。这将导致本已彻底崩溃的浮点计算反而绕过错误分支,打印出虚假的通过信息。 - 通过校验不等于环境正确:Validation 仅证明数组数值计算符合预期的代数递推,它完全不能证明线程是否正确绑核、页面是否落入本地 NUMA Node,也不能证明底层编译器是否生成了预期的向量化或流式写入指令。
8. 证据边界与六步核验清单#
在阅读或引用任何 STREAM 性能报告时,建议建立如下完整的证据闭环:
1. 校验工作集大小:参与运行的核心末级缓存总和 × 4 与 1,000,000 取大,确认数据路径跨出 LLC;
2. 审查逻辑字节公式:确认报告分子是否严格遵循 Copy(16B)、Scale(16B)、Add(24B)、Triad(24B);
3. 核对循环与分子对应:确认循环遍历上界与静态 bytes[] 宏定义采用完全一致的元素数量;
4. 确认时间汇总规则:剔除第 0 轮测量,采用有效轮次的 Min time 作为 Best Rate 分母;
5. 核实线程与页面放置:通过进程状态与 /proc 节点验证线程未漂移、内存物理页集中于目标 Node;
6. 检查数值与退出契约:数组最终状态通过校验,且校验具备拦截非有限数与返回非零退出码的能力。证据与版本约束#
- 本文关于标准 STREAM 内核、字节表、时间统计与校验重放的源码分析,基于官方规范 STREAM 5.10 C 基准版本(2013-01-17 发布版本,源码 SHA-256 见
evidence.yml); - 计时器精度分析基于
gettimeofday()的系统挂钟实现,实际运行受操作系统定时器粒度与上下文切换扰动; - OpenMP 屏障与并行调度基于 OpenMP 标准 worksharing-loop 语义,具体落点与迁移受运行时库实现(如 LLVM
libomp或 GNUlibgomp)及系统调度器配置约束。
本文采用 CC BY-NC-SA 4.0 许可。