阅读信息
- 内容类型:复盘
- 难度:中级
- 适合谁:懂 C 循环、正在分析 STREAM 异常结果的性能工程师
- 前置知识:数组循环和基本 STREAM 字节公式
- 读完后:移除十元素占位循环,为 Copy-only 和 Add-only 重建独立校验契约
- 依据版本:audited sources captured 2026-08-05; corrected release built 2026-08-05
- 验证日期:2026-08-22
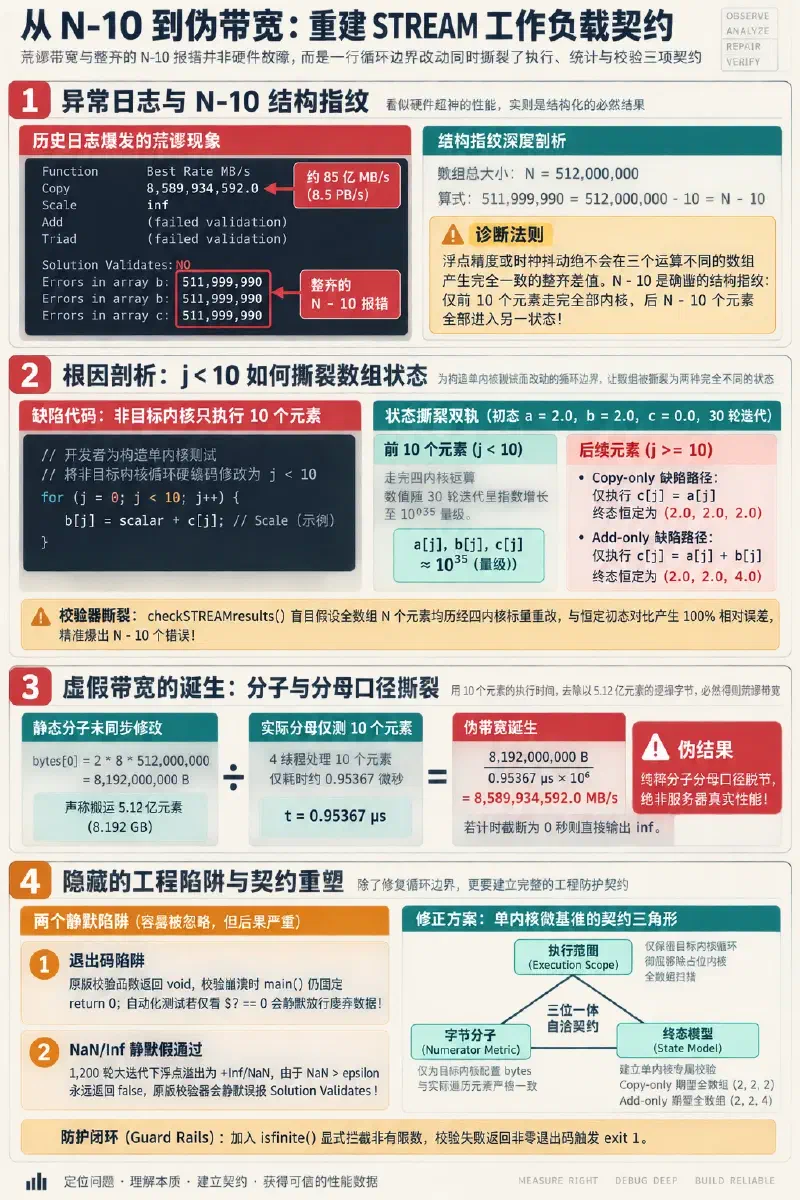
某批四核测试的历史日志中记录了一组荒谬的数值:程序报告 Copy 带宽高达 8,589,934,592.0 MB/s(约 85 亿 MB/s,即 8.5 PB/s),Scale 带宽直接显示为 inf。与该超大吞吐一同出现的,是紧随其后的校验崩溃:数组 a、b、c 各自整整齐齐地报错:
For array a[], 511999990 errors were found.
For array b[], 511999990 errors were found.
For array c[], 511999990 errors were found.
物理机器不可能瞬间提升八个数量级的吞吐。一个看起来是时钟或统计异常,另一个看起来是数据计算错误,它们为什么会在同一份日志中同时爆发?
排查最终锁定在微基准源码中一行不起眼的循环边界改动:
for (j = 0; j < 10; j++)这行代码最初被开发者用于“占位”,试图在保持四内核输出格式的同时只实际跑某一个内核。然而,这一改动直接切断了 STREAM 底层三项核心契约的自洽性,让执行工作量、带宽分子和校验模型完全脱节。
1. 现象分析:为什么 511,999,990 比 85 亿 MB/s 更具定位价值?#
面对数十亿 MB/s 的带宽,常见的候选怀疑方向包括:
- 计时区间过窄导致
gettimeofday()的微秒时钟分辨率不足; - 编译器执行了激进的死代码消除(DCE)直接删除了访存循环;
- 数组工作集全部落入某级高速 Cache;
- 输出打印时的单位换算存在溢出或乘除错误。
但上述假设都无法合理解释第二个现象:为什么三个大小为 512,000,000 元素的数组,各自不多不少,恰好报错 511,999,990 个元素?
普通浮点精度超标或容差 \(\epsilon\) 过严,错误往往与数值截断特征相关,不会在三个承担不同运算的数组上留下完全一致的整数差值;时钟精度不足也绝不会干涉数组内部具体哪些下标计算错误。N - 10 构成了一个确凿的结构指纹:数组中仅有前 10 个元素(下标 0 到 9)走完了预期路径,而后续所有的 \(N-10\) 个元素(下标 10 到 \(N-1\))全部进入了另一种完全不同的状态。
2. 根因剖析:j < 10 如何撕裂数组状态#
查看发生缺陷的审计源文件 stream_copy.c 与 stream_add.c,两份代码分别意图构造单内核测试:
- 在
stream_copy.c中,开发者希望只测 Copy,于是保留 Copy 循环处理全数组STREAM_ARRAY_SIZE,却将后面的 Scale、Add、Triad 的循环上限强行修改为10; - 在
stream_add.c中,开发者希望只测 Add,于是保留 Add 遍历STREAM_ARRAY_SIZE,而将 Copy、Scale、Triad 的循环上限改为10。
以 stream_copy.c 为例,其每轮实际执行的代码形如:
// Copy:完整数组遍历
#pragma omp parallel for
for (j = 0; j < STREAM_ARRAY_SIZE; j++)
    c[j] = a[j];

// Scale:硬编码只处理前 10 个元素
#pragma omp parallel for
for (j = 0; j < 10; j++)
    b[j] = scalar * c[j];

// Add:硬编码只处理前 10 个元素
#pragma omp parallel for
for (j = 0; j < 10; j++)
    c[j] = a[j] + b[j];

// Triad:硬编码只处理前 10 个元素
#pragma omp parallel for
for (j = 0; j < 10; j++)
    a[j] = b[j] + scalar * c[j];
回顾第 1 篇阐述的基准生命周期:数组经过初始化与时钟校准循环后,进入主循环时的统一全局初态为 \((a, b, c) = (2.0, 2.0, 0.0)\)。
在上述修改后的循环中,对于下标 \(j \ge 10\) 的所有元素:
- 第一轮 Copy 执行
c[j] = a[j],由于a[j] == 2.0,故c[j]被赋值为2.0; - 随后的 Scale、Add、Triad 循环条件
j < 10均不成立,\(j \ge 10\) 的元素被全部跳过; - 后续无论迭代多少轮,由于
a[j]和b[j]从未被写入,它们永久保持初态值2.0;c[j]也在每轮 Copy 中反复被赋予a[j]的值2.0。
因此,对任意 \(j \ge 10\) 的元素,其最终数值恒为:
$$ (a[j], b[j], c[j]) \equiv (2.0, 2.0, 2.0) \quad (\forall j \ge 10) $$而官方校验器 checkSTREAMresults() 根本不知道循环被截断,依然使用标量重放全部内核依次执行的四步递推:
仅迭代一轮,标量状态就变为 \((a_j, b_j, c_j) = (30.0, 6.0, 8.0)\)。在 30 轮历史配置下,该递推使得期望标量呈指数爆炸增长,最终期望值达到:
- \(a_j \approx 3.835021 \times 10^{35}\)
- \(b_j \approx 7.670042 \times 10^{34}\)
- \(c_j \approx 1.022672 \times 10^{35}\)
当校验器遍历数组对比时,下标 \(0 \le j < 10\) 的前 10 个元素因为真实走完了 30 轮四内核运算,数值与期望标量完全吻合;而其余 \(511,999,990\) 个元素停留在固定的 2.0,与 \(10^{35}\) 量级的期望值相比,相对误差均为 \(1.0\)(即 100% 相对误差,远超 \(\epsilon = 1.0 \times 10^{-13}\))。这就严密解释了为什么错误数量严格等于 \(N - 10\)。
3. 虚假带宽的诞生:分子与分母口径撕裂#
校验错误解释了数据层面的断裂,那么 85 亿 MB/s 与 inf 又是从何而来?
STREAM 源码计算带宽时,并不测量实际向总线发出了多少次访存请求,而是依赖静态初始化的逻辑字节表:
static double bytes[4] = {
    2 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE,
    2 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE,
    3 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE,
    3 * sizeof(STREAM_TYPE) * STREAM_ARRAY_SIZE
};
当 \(N = 512{,}000{,}000\) 且采用 8 字节双精度时,Copy 的分子固定为:
$$ \text{bytes}[0] = 2 \times 8 \times 512{,}000{,}000 = 8{,}192{,}000{,}000\text{ 字节} $$在 stream_add.c 中,开发者将 Copy 的循环改成了 for (j = 0; j < 10; j++),但完全没有同步修改 bytes[0]。
当程序运行该 Copy 内核时,CPU 实际上只对 10 个元素(80 字节)进行了读取和写入。在 4 线程并行下,处理 10 个元素耗时极短,系统定时器 mysecond() 捕获到的耗时往往仅有 1 微秒(\(1.0 \times 10^{-6}\text{ s}\))甚至更短:
若计时器捕获到的耗时在二进制时钟换算下略小(例如 \(0.95367\text{ }\mu\text{s}\)),算出的吞吐便正是日志中打印出的:
$$ 8{,}589{,}934{,}592.0\text{ MB/s} \quad (2^{33}\text{ MB/s}) $$若某轮循环耗时向下取整被记录为 0.000000 s,分母为零,浮点运算直接输出 inf。
分子声称自己搬运了 5.12 亿个元素,分母却只测量了 10 个元素的耗时。两个指标各说各话,制造出荒谬的数十亿 MB/s 伪带宽。
4. 隐藏的静默陷阱:为什么不能依赖 Shell 退出码?#
有人可能会提出:虽然被篡改的内核输出了荒诞数字,但我只看完整执行的那个内核(例如 stream_copy.c 里的 Copy,其报告了真实的 39,278.1 MB/s),这样得出的数据可不可信?
答案是绝对不可信,并且存在两个严重的工程陷阱:
陷阱一:原版 STREAM 5.10 校验失败不会产生非零退出码#
查看官方 stream.c 的实现:
void checkSTREAMresults() {
    ...
    if (abs(aAvgErr/aj) > epsilon) {
        err++;
        printf ("Failed Validation on array a[]...\n");
        ...
    }
    ...
}
该函数返回类型为 void。在 main() 函数末尾:
checkSTREAMresults();
printf(HLINE);
return 0;
即便三个数组累计输出了 15 亿次校验失败报错,进程退出的 Shell 状态码依然恒为 0:
$ ./stream_copy
...
Failed Validation on array a[], AvgRelAbsErr > epsilon
     For array a[], 511999990 errors were found.
$ echo $?
0
如果自动化测试脚本只通过 if [ $? -eq 0 ] 判定实验是否成功,就会将包含严重逻辑缺陷的数据全部判定为“测试通过”,进而写入数据库或生成基准报告。
陷阱二:大迭代轮次下的 NaN 与 Inf 静默假通过#
若将迭代轮数从 30 轮提升到工程测试常用的 1,200 轮,标量 \(a_j\) 会在几十轮内迅速突破 IEEE 754 双精度浮点数的上界(约 \(1.79 \times 10^{308}\))并溢出为 +Inf。
随后计算相对误差:
$$ \frac{|a[j] - aj|}{aj} \longrightarrow \frac{|\text{finite} - \infty|}{\infty} = \frac{\infty}{\infty} = \text{NaN} $$在 C 语言的浮点比较规则中,涉及 NaN 的任何大小比较(如 NaN > epsilon)在硬件与规范层面全部返回假(false)。原版校验器没有 isnan() 或 isfinite() 判断,导致本已彻底溢出的状态反而可能绕过 err++ 统计分支,在终端打印出虚假的 Solution Validates。
5. 契约重塑:单内核微基准的正确改造方案#
当系统测试因特定架构分析需要剥离单个内核时,绝不能通过“把其他内核截断为 10 个元素”的妥协手段来维持四行输出,而必须为目标内核单独建立自洽的执行、统计与校验契约。
在修正后的 stream-aocc-4core-trace 工具包中,Copy-only 与 Add-only 的契约被重新独立定义:
| 契约维度 | 缺陷实现(十元素占位) | 修正后的 Copy-only / Add-only 实现 |
|---|---|---|
| 循环结构 | 目标内核跑全量,其余跑 10 个元素 | 仅保留目标内核循环,彻底移除其余三个内核 |
| 分子口径 | 保留四项 bytes[],非目标项分子虚假 | 仅为目标内核配置 bytes,非目标项不参与统计 |
| 状态期望 | 强行使用四内核复合递推标量 | 基于单内核数学语义构建终态:Copy-only 期望全数组为 (2,2,2),Add-only 期望为 (2,2,4) |
| 有限数防护 | 无,NaN/Inf 可导致比较失效 | 显式使用 isfinite() 拒绝任何非有限浮点数 |
| 失败传播 | void 返回,主程序始终 exit 0 | 校验失败函数返回非零值,触发 exit 1 阻断流水线 |
以 Copy-only 的校验实现为例,状态模型得到彻底澄清:
int checkTraceResults() {
    // 初态为 a=2.0, b=2.0, c=0.0;经历全量 c[j]=a[j] 循环后:
    // a 保持 2.0,b 保持 2.0,c 变为 2.0
    for (j = 0; j < STREAM_ARRAY_SIZE; j++) {
        if (!isfinite(a[j]) || !isfinite(b[j]) || !isfinite(c[j])) {
            printf("Failed Validation: non-finite value detected at index %ld\n", (long)j);
            return 1;
        }
        if (fabs(c[j] - 2.0) > 1.0e-13) {
            printf("Failed Validation on array c[] at index %ld\n", (long)j);
            return 1;
        }
    }
    printf("Solution Validates (Copy-only single kernel contract)\n");
    return 0;
}
通过回归测试(包括人为注入错误数值与注入 NaN),验证了该实现不仅能正确放行合法运行,而且在数据受损时必定输出非零退出状态,使外层启动器与调度脚本能够可靠拦截异常。
6. 从本例提炼的性能排查原则#
j < 10 的教训表明:基准测试的数字无论看起来多么合理或荒谬,都必须回到三位一体的契约完整性:
- 执行边界一致性:各工作负载循环实际处理的数据量是否一致且符合测试设计?
- 统计分子对应性:报告带宽所采用的逻辑字节分子,是否严格由实际执行的数组长度与内核访存模型计算而来?
- 状态校验完备性:校验逻辑所依赖的期望模型是否与实际经历的运算步骤严格对称?校验是否覆盖全数组并防御非有限数?
- 失败阻断有效性:当数据不一致或环境异常时,程序能否通过进程退出码向外部系统传导失败?
只要这四个环节中存在任何一处隐瞒或割裂,得出的性能数据就丧失了科学评估的基石。
证据与可复核边界#
- 缺陷现象与复盘依据,来自 2026-08-05 采集的只读审计副本(
stream_aocc_copy_4core_0prf_ntaggressive.log与stream_aocc_add_4core_0prf_ntaggressive.log,哈希见evidence.yml); - 该历史运行参数为
N = 512,000,000、NTIMES = 30、4 线程;未保存当时编译产物的 ELF SHA-256,因此仅用于缺陷诊断与现象归因,不能用于跨构建性能横向对比; - 修正后的单内核微基准源码保存在
tools/stream-aocc-4core-trace/,已通过小数组回归注入测试与服务器 40.96 亿元素运行验证; - 1,200 轮配置下浮点溢出与
-Ofast激进优化可能导致 IEEE 754 异常行为在不同编译器版本间存在诊断文本差异,工程排查时应以显式有限数检查与内存状态为准。
本文采用 CC BY-NC-SA 4.0 许可。