阅读信息
- 内容类型:教程
- 难度:中级
- 适合谁:已理解 STREAM 指标、准备在目标服务器执行实验的工程师
- 前置知识:Linux 命令行和 STREAM 输出
- 读完后:只有运行计划、身份、放置、校验和产物同时闭环,结果才可复核
- 依据版本:stream-aocc-4core-trace release metadata (verified 2026-08-22)
- 验证日期:2026-08-22
终端打印出一行 72,383.9 MB/s,并不意味着一次严谨的性能测试已经完成。这个数字本身无法回答核心问题:运行的是哪一个 ELF 二进制?OpenMP 实际创建了多少线程、绑定在哪些核心?物理页面集中在哪个 NUMA Node?硬件预取器是否处于预期状态?数组计算是否全量通过校验?
本教程基于工作区 tools/stream-aocc-4core-trace/ 提供的标准启动器与微基准工具,以 Copy-only 单内核测试为例,演示如何从实验卡设计、参数预检(dry-run)、阶段感知就绪(readiness)、线程与页面实际观测,一步步走到严密校验与生成证据包。测试面向需要建立可复核证据链的系统与性能工程师。
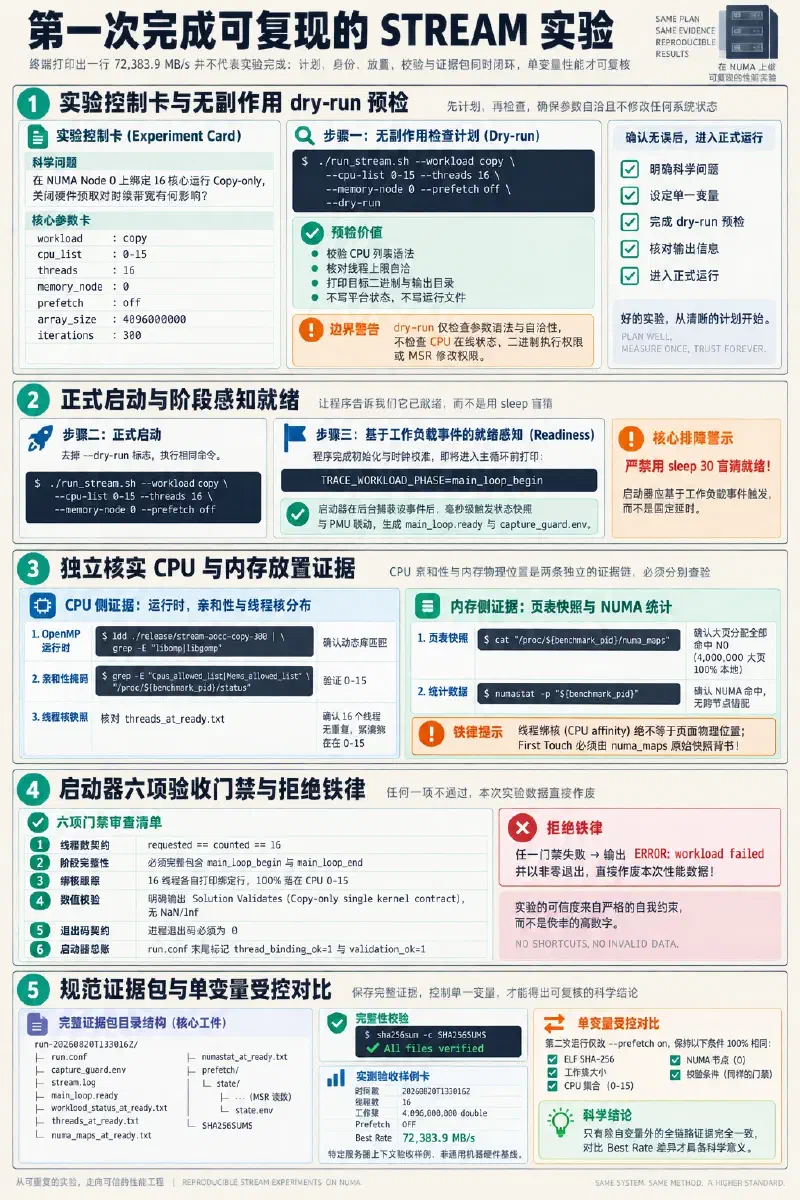
1. 明确实验问题与控制卡#
严禁在没有明确假设的情况下盲目运行基准测试。在敲下任何命令前,必须先写下一张明确的实验控制卡,把测试收敛为单一自变量:
experiment:
  question: 在 NUMA Node 0 上绑定 16 核心运行 Copy-only,关闭硬件预取对持续带宽有何影响?
  workload: copy
  cpu_list: 0-15
  threads: 16
  memory_node: 0
  prefetch: off
  array_size: 4096000000
  iterations: 300
  controlled_variables:
    - 相同的编译器与编译选项(AOCC 5.0 / -O3 -fnt-store=aggressive)
    - 相同的执行文件 SHA-256 身份
    - 相同的 CPU 核心集合(0-15)与本地 NUMA Node(0)
    - 相同的透明大页(THP)与系统调度状态
这张卡是后续验收的唯一标准。若运行产物中的任何一项实际观测与该卡矛盾,本次运行应被标记为无效,而不是在分析报告中打补丁或推测解释。
2. 使用 dry-run 验证计划,不触碰硬件状态#
启动器规范入口为 run_stream.sh(run_stream_4core.sh 作为兼容名称保留)。在目标服务器对应目录下执行带有 --dry-run 标志的命令:
./run_stream.sh \
  --workload copy \
  --cpu-list 0-15 \
  --threads 16 \
  --memory-node 0 \
  --prefetch off \
  --dry-run
执行后,启动器在标准输出打印出解析后的执行计划:
STREAM workload plan
  workload:    copy
  binary:      /path/to/release/stream-aocc-copy-300
  CPUs:        0-15
  threads:     16
  memory node: 0
  prefetch:   off (control dir: /srv/stream_test)
  output:      /var/tmp/stream-runs/stream_copy_16thread_YYYYMMDD_HHMMSS
DRY-RUN complete; no files written.
--dry-run 的核心价值在于以零副作用校验参数合法性:
- 校验
--cpu-list语法有效性,统计解析出的 CPU 数量(本例为 16); - 校验
--threads是否超过 CPU 列表总数(例如若传入--threads 17 --cpu-list 0-15,启动器会直接报错阻断); - 打印默认分配的目标二进制路径与输出目录结构。
注意边界:--dry-run 只检查输入语法和参数自洽性,它不检查 CPU 是否在线(Online)、不核验二进制是否存在可执行权限、不检查 numactl/stdbuf 依赖,也不校验 MSR 修改权限。这些前置依赖需在正式运行前由运维脚本或环境检查保证。
3. 正式启动与阶段感知:告别盲目 sleep#
在确认计划正确后,去掉 --dry-run 启动正式运行:
./run_stream.sh \
  --workload copy \
  --cpu-list 0-15 \
  --threads 16 \
  --memory-node 0 \
  --prefetch off
由于 40.96 亿个 double 元素初始化耗时较长,严禁用 sleep 30 或死循环等待来盲猜主循环何时启动。工作区修正后的程序在完成时钟校准并即将进入主测试循环前,会向标准输出输出结构化阶段标记:
TRACE_WORKLOAD_PHASE=main_loop_begin启动器内部的后台观察进程持续监控日志,在捕获该标记的瞬间(毫秒级)自动触发以下动作:
- 立即捕获被测进程在主循环启动瞬间的 CPU 亲和性与内存掩码(
/proc/<pid>/status); - 抓取被测进程全部线程的实时运行核快照(
ps -L -p <pid>); - 复制当前的 NUMA 映射表(
/proc/<pid>/numa_maps)与统计数据(numastat -p <pid>); - 写入阶段完成标记
main_loop.ready,并生成供外部联动采集工具(如 PMU 监控)使用的上下文文件capture_guard.env; - 在终端打印就绪提示:
READY for PatternCaptureTool: PID=<pid> log=<path>。
这种基于工作负载真实事件的就绪感知,彻底消除了不同机器由于数组大小或负载差异导致的未就绪抢跑与采样错位。
4. 独立核实线程位置与物理内存页分布#
“线程跑在哪里”与“内存分配在哪里”是两个完全独立的物理问题,必须分别查验独立证据。
线程位置核实#
首先核实进程使用的 OpenMP 运行时库。不同的编译器产物依赖不同的底层动态库:
ldd ./release/stream-aocc-copy-300 | grep -E 'libomp|libgomp'AOCC(基于 LLVM)通常链接 libomp.so,其亲和性环境变量遵从 OMP_PROC_BIND 与 OMP_PLACES;而 GCC 产物通常链接 libgomp.so。混淆运行时会导致绑核配置完全失效。
在程序运行期间(或检查启动器保存的快照),核对进程状态与线程快照:
benchmark_pid=1234
grep -E 'Cpus_allowed_list|Mems_allowed_list' "/proc/${benchmark_pid}/status"
查看输出中的 Cpus_allowed_list 是否严格等于 0-15,Mems_allowed_list 是否严格等于 0。
进一步核对 threads_at_ready.txt 中的线程明细。该文件通过 ps -L -o pid,tid,psr,stat,comm 记录了每个 OpenMP 线程在就绪时刻绑定的处理器编号(psr 列),确保所有 16 个线程无一例外散布在 0-15 核心上。
内存页面分布核实#
很多测试人员错误地认为:只要代码使用了 OpenMP 并行 for 初始化,First Touch 就必然会自动把内存完美分配到本地。事实是,线程迁移、系统默认内存策略、cpuset 限制以及自动 NUMA 均衡机制(numa_balancing)都有可能打破这一预期。
必须通过真实页表快照进行确认:
cat "/proc/${benchmark_pid}/numa_maps"
numastat -p "${benchmark_pid}"
在启动器留存的 numa_maps_at_ready.txt 中,定位 stream_copy 对应的大块匿名映射(每个 40.96 亿元素数组约为 30.5 GiB,总计约 91.5 GiB):
7f... default anon=4000000 dirty=4000000 active=0 N0=4000000 kernelpagesize_kB=2048确认大页的物理分布计数 N0 占据了 100% 的分配量,且 N1、N2 等远端节点计数为 0。结合 numastat_at_ready.txt 中的 numa_hit 与 numa_miss,确认不存在非预期的内存跨节点分配。
5. 验收门禁:六项条件决定接纳还是拒绝#
不要将目光只聚焦在最终打印出的性能表格上。启动器在主程序退出后,会自动执行严格的自动化判定:
- 线程数契约:日志中
Number of Threads requested与Number of Threads counted必须严格等于实验卡设定的 16; - 阶段完整性:日志中必须同时存在
TRACE_WORKLOAD_PHASE=main_loop_begin与main_loop_end,证明测试未中途崩溃或提前退出; - 绑核跟踪完整性:日志中 16 个线程各自打印的
TRACE_THREAD_BINDING thread=X cpu=Y必须全部落在 CPU 0-15 范围内,且无重复挤占; - 数值与有限数校验:日志必须明确包含
Solution Validates (Copy-only single kernel contract),且不能出现Failed Validation。任何NaN或Inf均会被校验器捕获; - 进程退出码:工作负载进程的 Shell 退出码必须为
0; - 启动器总账:审查输出目录下的
run.conf,其末尾必须显式标记:thread_binding_ok=1 validation_ok=1
若上述任何一项失败,启动器会在标准错误输出 ERROR: workload failed 并以非零状态退出。测试人员必须直接拒绝本次实验结果,切勿采信其中的任何吞吐数字。
6. 构建规范证据包,而非保存截图#
一次合格的性能实验,产物应当是一个包含完整上下文与机器指纹的证据包目录,结构如下:
stream_copy_16thread_YYYYMMDD_HHMMSS/
├── run.conf                       # 解析后的启动参数、主机名、时间戳与最终判定
├── capture_guard.env              # 记录 PID、日志路径、预取模式的现场环境快照
├── stream.log                     # 包含线程绑定日志、阶段标记、多轮计时与校验结果的完整输出
├── main_loop.ready                # 进入主循环时的时间戳标记文件
├── workload_status.txt            # 启动初期的进程状态快照
├── workload_status_at_ready.txt   # 就绪瞬间的 /proc/<pid>/status 记录
├── threads_at_ready.txt           # 就绪瞬间每个线程与 CPU 核的对应快照
├── numa_maps_at_ready.txt         # 就绪瞬间的内存页 NUMA 分布原始证据
├── numastat_at_ready.txt          # 就绪瞬间的 NUMA 命中与缺页统计
├── prefetch/
│   ├── control.log                # 预取设置脚本的执行日志
│   └── state/
│       ├── msr_readback_before.txt # 设置前全核心 MSR 原始读数
│       ├── msr_readback_after.txt  # 设置后全核心 MSR 原始读数
│       └── state.env               # 结构化预取有效性与观测状态(OBSERVED_STATE / STATE_VALID)
└── SHA256SUMS                     # 目录下所有证据文件的校验哈希清单
所有文件的哈希由启动器在退出前自动生成:
cd "/var/tmp/stream-runs/stream_copy_16thread_YYYYMMDD_HHMMSS"
sha256sum -c SHA256SUMS在工作区保存的基准运行样例(20260820T133016Z)中,16 线程、40.96 亿元素、关闭预取的 Copy-only 运行通过了上述全部门禁,报告持续带宽为 72,383.9 MB/s。该数值是特定硬件环境、AOCC 5.0 编译器、-fnt-store=aggressive 流式写入和指定绑核配置下的测量值,绝不能脱离完整的证据包被抽象引用。
7. 单变量受控对比:开启硬件预取#
为了回答实验卡最初提出的问题(预取对带宽的影响),进行第二次测试。此时必须保持所有其他因素绝对不变:
./run_stream.sh \
  --workload copy \
  --cpu-list 0-15 \
  --threads 16 \
  --memory-node 0 \
  --prefetch on \
  --run-name stream_copy_16thread_prefetch_on
两次运行结束后,将两个证据包中的参数填入对比表进行审查:
| 校验层级 | 首次运行(Prefetch OFF) | 第二次运行(Prefetch ON) | 是否为目标自变量 |
|---|---|---|---|
| ELF SHA-256 | a6d2eeb... | a6d2eeb...(同一二进制) | 否 |
| 工作集规模 | 4,096,000,000 double, 300 轮 | 4,096,000,000 double, 300 轮 | 否 |
| CPU 与线程 | CPUs 0-15, 16 线程紧凑绑定 | CPUs 0-15, 16 线程紧凑绑定 | 否 |
| NUMA 节点 | Node 0,全量本地内存命中 | Node 0,全量本地内存命中 | 否 |
| 硬件预取状态 | MSR 回读确认全核心关闭(Valid=1) | MSR 回读确认全核心开启(Valid=1) | 是(唯一自变量) |
| 数值校验 | Validation OK, 退出码 0 | Validation OK, 退出码 0 | 否 |
只有在确认除“硬件预取状态”之外的所有层级完全一致、且两次运行的原始 MSR 回读与数值校验全部真实有效的前提下,比较两次运行的 Best Rate 并计算提升百分比才具备统计与科学意义。
附录:实验条件与证据审查矩阵#
本矩阵用于运行后审查,也可直接作为实验设计与复核的自查清单。
总检查矩阵#
| 证据层 | 声明或意图 | 应保存的原始观测 | 通过条件 | 失败动作 |
|---|---|---|---|---|
| 构建身份 | 使用特定单内核微基准 | 源码与 ELF SHA-256、编译器版本、完整构建参数 | 实际运行二进制与固定哈希一致 | 不做跨构建归因 |
| 线程数量 | 请求 \(N\) 个并行线程 | 日志中 requested 与 counted 计数 | 两个计数相等且与设计值一致 | 拒绝运行并检查运行时库 |
| CPU 放置 | 线程紧凑绑定到目标核心 | /proc/<pid>/status、threads_at_ready.txt、日志中绑定行 | 所有线程 100% 位于目标 CPU 集合内 | 不解释绑核效果,视为污染 |
| NUMA 策略 | 内存优先分配自目标 Node | Mems_allowed_list、numa_maps_at_ready.txt | 物理页 100% 命中目标 Node | 不宣称本地内存带宽 |
| 平台状态 | 硬件预取开启或关闭 | prefetch/state/ 下全核心原始 MSR 读数 | STATE_VALID=1 且观测状态匹配 | 拒绝将差异归因于预取 |
| 写入指令 | 使用流式写入(NT-store) | 编译器优化报告、LLVM IR 或反汇编指令 | 目标循环确认生成预期流式存储指令 | 仅作为编译意图,不作物理断言 |
| 数值有效性 | 数组计算无损且完成 | 显式有限数检查、单内核目标终态校验、退出码 | 全数组扫描通过,进程 exit 0 | 彻底作废本次性能数据 |
| 数据稳定性 | 测量处于稳态区间 | 多轮计时数据(Avg/Min/Max 与各轮离散度) | 无异常长耗时轮次,波动在可控阈值内 | 重新排查后台系统干扰 |
审查要素细化#
- 构建与身份要素:
文件名相同绝不代表程序相同。构建审查必须绑定:源码 SHA-256、ELF SHA-256、编译器绝对路径与版本(如 AOCC 5.0.0 / AMD clang 17.0.6)、完整编译选项(包含
-O3 -fnt-store=aggressive等宏)、数组大小宏(STREAM_ARRAY_SIZE)与迭代轮数宏(NTIMES)。若服务器运行工件未记录执行文件自身的 SHA-256,则只能证明指定路径产生了输出,不能证明其与本地 release 逐字节一致。 - 线程与亲和性要素:
确认实际链接的 OpenMP 运行时库,避免 GNU 环境变量(
GOMP_CPU_AFFINITY)与 LLVM 运行时库(libomp)混用。进程状态快照仅代表采样瞬间的状态;若需严格证明全程无漂移,需结合测试中每个线程的自主输出与连续追踪。 - 平台状态要素: 严禁脱离 MSR 原始回读推断硬件预取状态。任何仅根据脚本传入参数或外部配置字段作出的“预取已关”断言均不可采信。
- 结论收敛原则: 在审查过程中,如果任何一项证据缺失或存在疑点,正确且唯一的处理方式是主动收敛结论范围,坦白记录“该项未获得充分证据支持”,绝不允许使用常识推测或编写看似合理的假设来掩盖证据链缺口。
本文采用 CC BY-NC-SA 4.0 许可。