阅读信息
- 内容类型:操作指南
- 难度:高级
- 适合谁:已有 Experiment Run 或单路 PCT capture、需要判断证据是否可用的性能工程师
- 前置知识:JSON、CSV、Trace Run 基本布局
- 读完后:怎样选择正确的 pattern-trace 子命令,并在不破坏原始证据的前提下验证或重分析 Trace?
- 依据版本:<TRACE_HOST> Pattern Trace Parser 4.1.3 verified 2026-08-23
- 验证日期:2026-08-23
在测试机生成的真实分析报告中,往往会同时看到如下判断:
analysis_status = complete
evidence_status = usable
warning = ccm_pmu_trend_deviation (-64.199%)这一组合并非系统内部逻辑自相矛盾:usable 确认了用于支撑核心结论的证据门已全部通过;而 warning 则标明了指标在物理测量层面的解释边界——CCM 仅反映处理器核心发出的 Request Path 流量趋势,不能直接等同于物理 DRAM 的实际字节吞吐。
因此,运行 pattern-trace 的核心目标绝不只是“把二进制 raw 转成可读文本”,而是为整个实验闭环建立三道把手:校验输入证据链的完整性、执行硬件层面的分析资格门、并在明确口径边界的前提下发布分析结论。
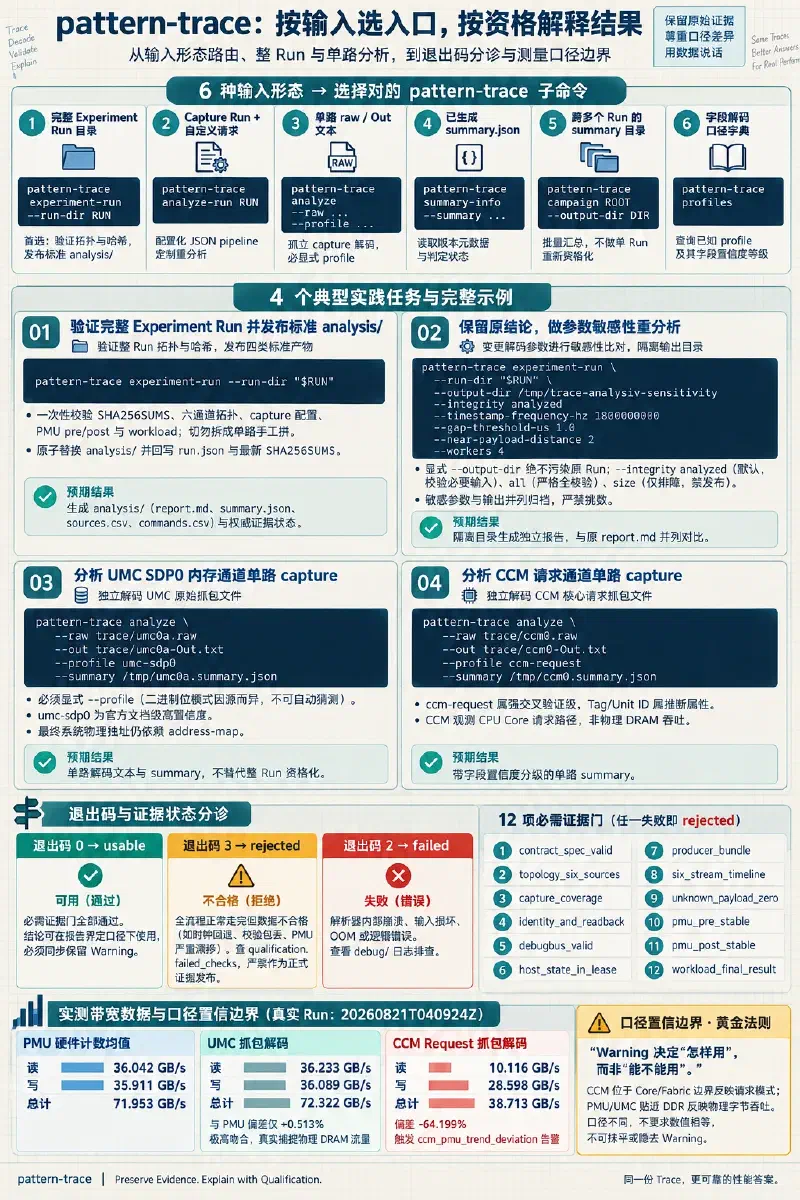
1. 按输入层级路由子命令#
在 <TRACE_HOST>(Parser 4.1.3)环境下,pattern-trace 针对不同的输入粒度提供了专门的子命令:
| 输入数据形态 | 首选命令 | 适用场景与边界 |
|---|---|---|
| 完整 Experiment Run 目录 | pattern-trace experiment-run --run-dir RUN | 验证整 Run 拓扑与哈希,发布标准 analysis/ 产物 |
| Capture Run + 自定义请求 | pattern-trace analyze-run RUN | 基于配置化 JSON pipeline 进行定制化或实验性重分析 |
| 单路 raw / Out 文本文件 | pattern-trace analyze --raw ... --profile ... | 孤立 capture 文件解码,必须显式指定硬件 source profile |
已生成的 summary.json | pattern-trace summary-info --summary ... | 读取当前或 legacy summary 的版本元数据与判定状态 |
| 跨多个 Run 的 summary 目录 | pattern-trace campaign ROOT --output-dir DIR | 批量汇总多组实验数据,不做单 Run 证据重新资格化 |
| 字段解码口径字典 | pattern-trace profiles | 查询已知硬件 profile 及其字段置信度等级 |
如果手头已有一份由 experiment run 产出的完整 Run 目录,切勿逐个抽取 .raw 文件调用 analyze 并手工汇总数据。标准 Experiment Run 包含六路 capture 的时序交织、硬件拓扑映射、采集前后的 PMU 基线对比以及 workload 运行状态;只有 experiment-run 子命令能同时校验整条证据链并给出合规的资格判定。
2. 标准 Pattern Run 的自动分析与产物核对#
在标准的测试流程中,experiment run 会在硬件采集结束且所有 collector 退出后,自动调用 Parser 完成分析:
pattern-trace experiment-run --run-dir "$RUN"因此,正常情况下无需手工重跑分析。进入分析工作流的第一步是核对当前 Run 的状态:
experiment show "$RUN"当返回的 run.analysis.status 为 usable 或 rejected 时,说明分析流水线已执行完毕,直接读取 $RUN/analysis/ 目录下的四类标准产物:
analysis/
  ├── report.md        # 人类可读报告:结论摘要、资格门检查项、告警与测量口径
  ├── summary.json     # 机器可读指标:完整状态、带宽统计、failed_checks 清单
  ├── sources.csv      # 分通道数据:各 DebugBus source 的包数、有效负载与带宽
  └── commands.csv     # 命令分布表:各硬件操作码(如 Rd/Wr/Flush)的时序频次
自动化脚本可通过 summary.json 提取核心状态与资格门结果:
# 提取分析状态与失败检查项
jq '{status: .analysis.status, failed_checks: .qualification.failed_checks}' "$RUN/analysis/summary.json"

# 查看分通道流量(UMC 与 CCM)
head -n 10 "$RUN/analysis/sources.csv"
在更新标准产物时,Parser 严格遵循原子发布流程:首先验证原 Run 中 SHA256SUMS 记录的全部原始文件;确认无篡改后在临时目录中生成分析结果;随后原子替换整个 analysis/ 目录;接着回写 run.json 中的 Parser 版本与分析状态;最后重新计算并生成覆盖整 Run(包含新 analysis/ 产物)的最新 SHA256SUMS。如果前期哈希校验失败,Parser 会立即中断,绝不污染或破坏现有 Run。
3. 需要重分析时先保护原结论#
当需要变更解码参数(如时钟频偏、gap 阈值)进行敏感性比对,或者需要使用新的配置化规则时,必须通过显式指定 --output-dir 将新结果输出至隔离目录:
pattern-trace experiment-run \
  --run-dir "$RUN" \
  --output-dir /tmp/trace-analysis-sensitivity
使用独立输出目录可以确保原始 Run 内部的权威 analysis/ 产物不受任何变更干扰。
3.1 完整性校验级别选择#
重分析支持三种输入校验模式(--integrity):
pattern-trace experiment-run --run-dir "$RUN" --output-dir /tmp/output --integrity analyzed--integrity analyzed(默认模式):仅校验本次分析实际需要读取的输入文件(如 raw trace、拓扑映射、PMU 计数),在保障证据有效性的同时避免对无关大文件进行冗余校验;--integrity all:校验原 Run 中SHA256SUMS登记的每一个文件,适用于正式发布重分析结论前的最终合规性核验;--integrity size:仅核对文件大小,不计算哈希。仅供定位 I/O 性能瓶颈或调试脚本逻辑使用,不得用于发布正式证据。
3.2 解码敏感性参数调优#
当特定硬件平台的总线时钟与标称值存在微小频偏,或数据流中存在非典型突发时,可通过微调解码参数进行敏感性分析:
pattern-trace experiment-run \
  --run-dir "$RUN" \
  --output-dir /tmp/trace-analysis-sensitivity \
  --integrity analyzed \
  --timestamp-frequency-hz 1800000000 \
  --gap-threshold-us 1.0 \
  --near-payload-distance 2 \
  --workers 4
各核心参数的物理含义如下:
--timestamp-frequency-hz:设置时间戳转换基准频率(例如 1.8 GHz)。频率漂移会直接影响带宽计算分母;--gap-threshold-us:包流间隔超出该阈值(微秒)时判定为通信停顿,用于切分突发传输窗口;--near-payload-distance:数据包与其关联控制包之间的最大判定距离(包个数);--workers:多路 trace 解码的并行进程数。
变更这些参数可能导致带宽计算值或资格门判定产生波动。在形成实验结论时,必须将调参后的输出目录、完整执行命令行与原 report.md 并列归档,严禁只挑选“符合预期”的数字。
3.3 配置化 v3 Pipeline 分析#
对于需要应用非标准聚合算法或自定义过滤器的场景,使用 analyze-run 命令配合 JSON 规格书:
pattern-trace analyze-run "$RUN" \
  --config analysis-request.json \
  --output-dir /path/to/custom-output \
  --workers 4
或通过标准输入直接传入配置:
cat << 'EOF' | pattern-trace analyze-run "$RUN" --config-stdin --output-dir /tmp/custom-run
{
  "schema": "hygon.trace-analysis-request/v3",
  "pipeline": "custom-window-evaluation",
  "window_us": 500,
  "sources": ["umc-sdp0", "ccm-request"]
}
EOF
分析请求 JSON 必须包含合规的 schema 版本标识,并与分析产物一并留存以备复核。
4. 单路 Capture 必须显式选择 Profile#
当脱离标准 Experiment 框架,对单独抓取的 .raw 硬件文件进行离线分析时,必须使用 pattern-trace analyze 并显式指定 --profile。
4.1 分析 UMC SDP0 内存通道#
pattern-trace analyze \
  --raw trace/umc0a.raw \
  --out trace/umc0a-Out.txt \
  --profile umc-sdp0 \
  --summary /tmp/umc0a.summary.json
4.2 分析 CCM 请求通道#
pattern-trace analyze \
  --raw trace/ccm0.raw \
  --out trace/ccm0-Out.txt \
  --profile ccm-request \
  --summary /tmp/ccm0.summary.json
核心辅助选项:
--events:在输出解码文本的同时,将检测到的硬件事件序列输出至独立事件流;--include-idle:保留总线无传输时的 Meta 0 / Data 0 空闲心跳包,用于评估总线利用率与占空比;--force:若目标输出文件已存在,默认会报错中止;加上--force后将原子覆盖目标文件。
4.3 Profile 为什么不能自动猜测#
硬件采集层(PatternCaptureTool)输出的原始数据是特定 DebugBus 引脚上的二进制流。相同的位模式在不同的总线源上代表完全不同的硬件协议:某一特定偏移处的比特在 UMC 视角下是内存通道地址线,在 CCM 视角下则是事务 Tag 或缓存一致性操作码。
运行 pattern-trace profiles 可查看官方支持的 Profile 及其字段置信度等级:
pattern-trace profilesumc-sdp0(高置信度):内存控制器的 SubChannel SDP0 请求负载。其command、length与address字段拥有明确的硬件技术文档支撑;但最终的系统物理地址映射依然依赖平台的 address-map 配置转换;ccm-request(强交叉验证):CCM 请求负载。其结构源于历史位段划分、实时 I/O 内存转储与 MAP 命令的联合反推交叉验证。虽然关键命令与长度字段高度可信,但缺少官方公开的权威硬件位定义表,部分内部事务 Tag 与 Unit ID 字段在属性定义上仍属于候选推断。
解析器能解析出字段,绝不意味着该字段享有同等权威级别的官方规范定义。
5. 用退出码和 Evidence Status 分流#
pattern-trace 遵循严格的返回码与状态映射:
| 退出码 | 判定状态 | 含义与处置指引 |
|---|---|---|
0 | usable | 必需证据门全部通过。结论可在报告界定的口径下使用,需同步保留 Warning |
3 | rejected | 分析逻辑完整执行,但证据资格门未通过。严禁作为合格性能数据发布 |
2 | failed | 解析器内部异常、输入文件损坏、参数配置错误或运行资源超限 |
特别注意区分 rejected 与 failed:
rejected(退出码 3)表明解码器正常走完了全流程,但数据本身未能通过预设的质量验收标准(例如时钟回退、校验包丢失、前后 PMU 严重漂移);failed(退出码 2)则是分析工具本身由于文件缺失、OOM 或逻辑错误而未能产出有效结果。
现场分诊流程应严格按如下层级推进:
experiment show "$RUN"
  ├─ integrity invalid      → 输入文件哈希不匹配,先排查存储损坏或人为修改
  ├─ capture failed         → 硬件采集流水线异常,排查 workload 与 collector 状态
  └─ capture succeeded
       ├─ analysis usable   → 状态正常;读取 report.md 中的 Warning 与口径限制
       ├─ analysis rejected → 证据不合规;查阅 qualification.failed_checks 定位失效门
       └─ analysis failed   → 解析器执行崩溃;查看 debug/ 日志与系统资源
在真实合格 Run 20260821T040924Z 中,解析器严格核验了如下 12 项必需门禁,全部通过后方才判定为 usable:
contract_spec_valid:契约规范合法topology_six_sources:完整六通道拓扑对齐capture_coverage:各通道采样覆盖窗口达标identity_and_readback:硬件回读身份与计划声明一致debugbus_valid:DebugBus 信号使能有效host_state_in_lease:硬件控制寄存器租约期间未被外部篡改producer_bundle:驱动与二进制工具版本指纹一致six_stream_timeline:六通道时序全局单调递增unknown_payload_zero:无无法识别的异常数据包pmu_pre_stable:前置 PMU 基线平稳pmu_post_stable:后置 PMU 基线平稳workload_final_result:被测负载正常退出并产生有效指标
若其中任意一项失败,状态即降级为 rejected,对应失败项会详细记入 summary.json 中的 failed_checks 列表。
6. Warning 决定“怎样用”,而非“能不能用”#
在上述真实 Run 中,生成的 report.md 包含如下实测带宽对照数据:
| 观测层级 | 读吞吐 (GB/s) | 写吞吐 (GB/s) | 总吞吐 (GB/s) |
|---|---|---|---|
| PMU 硬件计数均值 | 36.042 | 35.911 | 71.953 |
| UMC 抓包解码 | 36.233 | 36.089 | 72.322 |
| CCM Request 抓包解码 | 10.116 | 28.598 | 38.713 |
数据对比显示:
- UMC 与 PMU 吻合度极高:UMC 抓包计算的总带宽与底层 PMU 均值之间的相对偏差仅为
+0.513%。这证明 UMC 抓包真实捕捉到了内存控制器物理通道上的实际数据流; - CCM Request 存在显著偏差:CCM 测算带宽相比 PMU 均值偏差达
-64.199%,且写流量(28.598 GB/s)显著高于读流量(10.116 GB/s)。
这一偏差触发了 ccm_pmu_trend_deviation 警告。正确的技术处理方式既不是废弃整份报告,也不是强行将 CCM 数据修正抹平,而是根据其物理测量位置界定使用范围:
- 观测点不同:PMU 与 UMC 观测点紧邻物理 DDR 通道,统计的是实际进入 DRAM 颗粒的物理突发数据;而 CCM 位于 CPU Core/L3 与 Data Fabric 的互联边界,观测的是上层发送的请求事务包;
- 缓存与协议开销过滤:部分读请求在末级缓存命中而未下发至 CCM,而非时序写入可能在内部队列中完成聚合;且 CCM 请求包仅代表发起操作,不包含 DRAM 突发传输所需的突发填充字节;
- 口径隔离:报告正式结论中,PMU 与 UMC 负责回答“DRAM 物理总线实际承担了多少带宽”,而 CCM 仅用于分析“计算核心发出了何种模式的访存请求”。
对于测试中可能遇到的其它告警(如 Error Data 校验包、时间戳微小修复、包去重敏感度等),均应在报告明示的物理约束下采信数据,不得隐去 Warning。
7. Taiji 导出与当前版本边界#
在本地源码仓库中,工作树包含 pattern-trace taiji-export 子命令的完整实现与单元测试,用于将 PCT raw 数据转换为 Taiji 格式以供离线回放。
但在 2026-08-23 对 <TRACE_HOST> 测试机的环境核对中:
pattern-trace --help服务器当前的 CLI 表面并未部署 taiji-export。
在编写生产自动化脚本或操作手册时,必须以目标服务器实际交付的 CLI 能力为准。本地工作树中的未部署代码只能作为机制分析的参考,不能写成测试机当前可用的操作指令。
本文采用 CC BY-NC-SA 4.0 许可。