阅读信息
- 内容类型:解释
- 难度:中级
- 适合谁:初次接触 MAP/SPARTA、需要继续阅读上层性能模型的架构与验证工程师。
- 读完后:读完后,读者能够判断一个 SPARTA 模型在什么逻辑时间、哪个调度阶段执行回调,并沿端口和事件解释一笔事务从发送到接收的最早可见时间。
- 依据版本:MAP/SPARTA source snapshot verified 2026-08-23
- 验证日期:2026-08-23
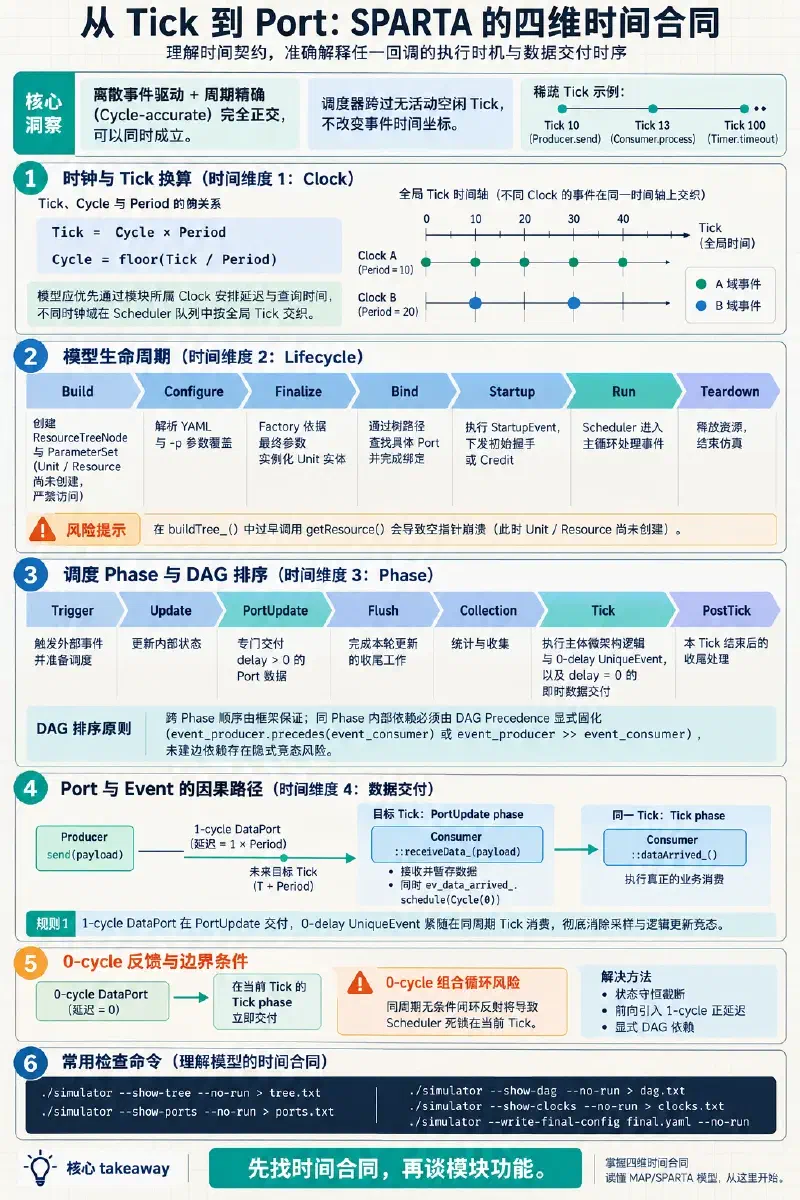
一个仿真器如果能从 Tick 10 直接跳到 Tick 100,它还能叫“周期精确”吗?
可以。事件驱动(Event-driven)回答的是“时间怎样向前推进”,周期精确(Cycle-accurate)回答的是“状态转移以什么粒度发生”。这两个维度完全正交:调度器可以跨过没有任何活动的空闲区间,直接跳到下一个事件,同时保证每个延迟、端口回调与内部状态更新都严格对齐到目标时钟周期与调度阶段。
阅读 SPARTA 框架及其上层性能模型时,最大的障碍通常不是 C++ 语法,而是对时间契约的模糊认知。本文通过剖析 SPARTA 的 Scheduler、Clock、Event、Port 与生命周期机制,建立阅读源码所需的时间心智模型。读完后,读者能够明确判断任意回调在哪个 Tick、哪个 Phase 执行,解释 0-cycle 与 N-cycle Port 的交付时序,并识别无终止条件的组合环与同阶段竞态风险。
1. 区分仿真器的五个正交维度#
在讨论仿真器架构时,“这是 event-driven 还是 cycle-driven?”往往把多个正交问题混为一谈。分析具体的性能模型时,应从以下五个维度分别定位:
| 维度 | 常见分类 | 该维度回答的核心问题 |
|---|---|---|
| 时间推进(Time Advance) | Fixed-step(固定步长)、Discrete-event(离散事件) | 仿真器是在每个时间步轮询所有模块,还是直接跳跃到下一个事件时间点? |
| 时序精度(Timing Accuracy) | Untimed、Loosely timed、Approximately timed、Cycle-accurate、Signal-accurate | 模型把时钟刻度精确到事务粗粒度、时钟周期,还是时钟边沿/信号电平? |
| 驱动源(Workload Driver) | Trace-driven、Execution-driven、Full-system | 输入是离线固定的指令/事务轨迹,还是由模拟核动态执行指令并产生反馈? |
| 通信粒度(Granularity) | Transaction-level(TLM)、Packet/Flit-level、Pin/Signal-level | 模块间接口传递的是高层 C++ 结构体、网络包,还是按位信号? |
| 建模目的(Modeling Goal) | Functional(功能仿真)、Performance(性能模型)、Hybrid(混合模型) | 建模关注的是架构指令行为的正确性,还是微架构流水线资源的占用与延迟? |
基于这一分类体系,SPARTA 典型模型通常可以同时具备以下特征:
离散事件驱动 (Discrete-event)
+ 周期精确 (Cycle-accurate)
+ 事务/结构级 (Transaction / Packet)
+ 执行驱动或轨迹驱动 (Execution / Trace-driven)
+ 性能模型 (Performance Model)
离散事件机制绝不意味着“时序不精确”。如果一个模块计算出某笔事务需要 3 个本地周期完成,它会通过绑定的 Clock 把“3 个周期后”换算成确定的全局 Scheduler Tick,并在该 Tick 触发完成回调。在没有事件发生的中间周期,硬件处于静止状态,仿真器无需空转轮询,从而大幅提高仿真吞吐。
2. SPARTA 是框架,不是现成处理器模型#
在 MAP 体系中,SPARTA 扮演的是“仿真建模运行时与基础库”的角色,其核心职责包括对象树层次管理、离散事件调度、端口通信、参数化配置和统计框架;而可视化与数据分析则由 Helios 等工具承载。SPARTA 本身并不预置一套具体的 CPU 核或 NoC 拓扑,它为开发者提供了构建这类模型的标准抽象。
阅读基于 SPARTA 的性能模型源码时,核心对象与对应的问题如下:
| 核心抽象 | 源码对应的主要职责与阅读重点 |
|---|---|
TreeNode / ResourceTreeNode | 构成层次树的节点。ResourceTreeNode 将 Factory、ParameterSet 与 Unit 绑定在一起。 |
ParameterSet | 模块的参数集合,支持从架构文件、YAML 配置或命令行 -p 进行层级覆盖。 |
Clock | 描述时钟域。负责将所属模块的本地 Cycle 换算为全局 Tick。 |
Event / UniqueEvent / PayloadEvent | 逻辑回调单元。确定回调在哪个 Tick、哪个 Phase 执行,是否允许同一周期重复调度。 |
DataPort / SignalPort | 模块间通信端点。定义延迟(0-cycle 或 N-cycle)以及交付数据的调度阶段。 |
Scheduler / DAG | 全局时间主控器。驱动事件队列前进,并通过有向无环图(DAG)维护同阶段事件的相对先后。 |
Counter / StatisticDef / SpartaLogger | 可观测性基础设施。用于统计流水线利用率、吞吐并记录调试诊断日志。 |
Scheduler Tick 与 Clock Cycle 的换算关系#
Scheduler 的基本时间基准是整型 Tick。每个具体的 Clock 拥有其固定周期(Period,以 Scheduler Tick 为单位),负责在本地时钟域周期与全局 Tick 之间换算:
在公开源码 sparta/simulation/Clock.hpp 中,Clock::getTick() 与 Clock::getCycle() 严格按照上述算式实现 [SRC]。源码注释特别警示:模型代码应优先通过所属模块的 Clock 安排延迟和查询时间,而不是直接依赖裸 Tick。 这一设计允许不同模块运行在不同频率(例如 CPU Core 时钟域与 Memory Controller 时钟域拥有不同的 Period),多时钟域事件在全局统一的 Scheduler 队列中以绝对 Tick 为基准正确交织。
3. Scheduler 怎样跳过空闲时间#
将 Scheduler 理解为按时间递增维护的稀疏日程表,而非硬件脉冲发生器。其核心推进逻辑可抽象如下:
while (running && has_events) {
    TickQuantum* quantum = current_tick_quantum_;
    current_tick_ = quantum->tick;

    for (auto& phase_group : quantum->ordered_phase_groups) {
        for (auto* event : phase_group) {
            event->invokeHandler();
        }
    }

    current_tick_quantum_ = quantum->next;
}
公开源码 Scheduler::run() 表明,调度器每次循环直接将 current_tick_ 跃迁至下一个包含未决事件的 TickQuantum 所在的 tick,遍历该 Tick 下按 Phase 排序的事件集合,随后直接将指针推进至更后方的非空 Quantum [SRC]。
若事件队列中仅存在以下三笔调度:
Tick 10:  Producer.send()
Tick 13:  Consumer.process()
Tick 100: Timer.timeout()
Scheduler 的实际观察点直接呈现为 10 → 13 → 100。在 14 到 99 之间没有任何事件,仿真循环直接跨过这 86 个 Tick,完全不产生冗余调用。
建模失效边界: 这种跳跃机制对模型完备性提出了严格要求。如果某个硬件状态理应每个周期都递变(例如动态功耗积分或简单的漏桶限速),开发者必须显式将其安排为重复事件,或者将其重构为“在被访问时根据当前周期差惰性推导计算”的数学模型。若既无事件又未做惰性补偿,跳过空闲周期将直接导致状态静止或时序统计失真。
4. 构建生命周期:Build、Configure、Finalize 与 Bind#
SPARTA 严禁在 C++ 构造函数中直接假设相邻模块已经存在并建立通信。模型构建严格划分为六个阶段:
[1. Build]      创建 ResourceTreeNode 与 ParameterSet
     ↓
[2. Configure]  解析 YAML 与命令行 -p 参数,覆盖配置
     ↓
[3. Finalize]   基于最终参数调用 Factory,实例化 Unit (Resource)
     ↓
[4. Bind]       通过树路径查找具体 Port 并完成绑定
     ↓
[5. Startup]    执行 StartupEvent,发出第一批握手信号或初始 Credit
     ↓
[6. Run]        Scheduler 进入主循环,处理离散事件
各阶段职责与防错机制如下:
- Build(树结构搭建): 开发者实现
buildTree_(),在层次树中挂接ResourceTreeNode,并关联对应的ResourceFactory与默认ParameterSet。此时具体的业务 C++ 类(如Producer或Consumer)尚未实例化。 - Configure(参数固化): 框架读取架构配置文件、YAML 描述及命令行
-p/--parameter选项,将外部输入覆盖到ParameterSet中。在参数稳定前,不能提前依据参数确定模块内部缓冲区大小。 - Finalize(资源实例化): 框架递归调用
ResourceTreeNode::finalize(),由 Factory 根据固化后的参数构造具体的Unit实例。至此,模块内部的数据结构、Port 与 Event 内存分配完毕。 - Bind(端口互联): 在
bindTree_()中通过绝对或相对路径(如"producer.ports.out_port")获取各模块的 Port 指针,调用sparta::bind()建立虚连接。 - Startup(启动阶段): Scheduler 在正式推进 Tick 之前,执行所有注册在
sparta::StartupEvent上的回调。此阶段用于发送第 0 个周期的激活信号或初始化 Credit 账本。 - Run(运行时): 事件队列开始推进。
常见违规模式: 若在 buildTree_() 中过早调用 node->getResource(),会立即得到空指针并触发运行时断言崩溃。所有跨模块引用与端口绑定必须严格延后至 Finalize 之后的 bindTree_() 阶段。
5. 同一 Tick 内的七个调度阶段与 DAG 排序#
即使多项操作都发生在“Tick 100”,它们在同一个 Tick 内部依然存在严格的时间切片。sparta/kernel/SchedulingPhases.hpp 明确定义了七个调度阶段的绝对执行顺序 [SRC]:
Trigger
  ↓
Update
  ↓
PortUpdate
  ↓
Flush
  ↓
Collection
  ↓
Tick
  ↓
PostTick
各阶段的微架构语义分工明确:
Trigger:处理时钟沿触发信号与外部激励输入。Update:更新流水线寄存器、队列指针与内部状态机。PortUpdate:专门交付延迟大于 0 cycle 的 Port 数据。接收方的数据回调在此时被调用。Flush:响应分支预测错误或异常触发的流水线冲刷。Collection:采集流水线数据,用于 Pipeline 收集器与图形化调试。Tick:执行主体微架构逻辑、绝大多数普通Event,以及 0-cycle Port 的即时数据交付。PostTick:周期末尾收尾工作、诊断断言核查与末期度量采集。
阶段内顺序与 DAG Precedence#
框架保证不同 Phase 之间的先后顺序,但在同一个 Phase 内部,多个 Event 的默认执行顺序由内部容器决定。sparta/kernel/Scheduler.hpp 明确指出:同一 Phase 内未指定优先级的事件,在单次编译的二进制中通常保持固定,但在更换编译器、重构源码或调整声明顺序后,其相对顺序可能会意外颠倒 [SRC]。
当同一个 Phase 内的两个 Event 存在因果依赖(例如必须由 Unit A 先计算结果、Unit B 再取用)时,开发者必须通过 DAG(有向无环图)显式建立 precedence:
// 显式声明 event_producer 必须在同一 Phase 内先于 event_consumer 执行
event_producer.precedes(event_consumer);
// 或使用重载操作符语法
event_producer >> event_consumer;
未定义 DAG 边的同阶段依赖是性能模型中最隐蔽的竞态缺陷来源之一,通常表现为“在 Debug 模式下通过、Release 模式下计算结果不同”或“新增无关成员变量后行为突变”。
6. 0-cycle Port 与 N-cycle Port 的时序剖析#
sparta::DataInPort 的构造函数对延迟有明确的调度路由规则(见 DataPort.hpp:326-344):delay 等于 0 时,数据在 Tick phase 交付;delay 大于 0 时,数据在未来的 PortUpdate phase 交付 [SRC]。
N-cycle Port:跨周期的标准数据通道#
设端口声明为延迟 1 个周期:
sparta::DataInPort<uint32_t> in_port{&unit_port_set_, "in_port", 1};当上游模块在 Tick \(T\)(无论处于 PortUpdate 还是 Tick phase)调用 out_port.send(payload) 时:
- 框架根据接收端 Clock 将 1 cycle 换算为调度目标时间 \(T + \text{Period}\);
- 数据交付事件被挂入目标 Tick 的
PortUpdate阶段; - 在 Tick \(T + \text{Period}\) 的
PortUpdate阶段,接收端注册的回调receiveData_(payload)准时执行; - 接收端通常在
receiveData_()中将数据存入内部临时变量或队列,并调度一个 0-delay 的内部UniqueEvent; - 紧随其后,在同周期的
Tick阶段,该UniqueEvent触发,执行真正的消费逻辑。
这种“PortUpdate 接收数据 \(\to\) 同周期 Tick 业务消费”的两段式设计,彻底消除了硬件时钟沿采样与组合逻辑更新之间的交织竞态。
0-cycle Port:同一周期内的组合与反馈#
当端口声明为 delay = 0 时:
sparta::DataInPort<uint32_t> in_credit_port{
    &unit_port_set_, "in_credit_port",
    sparta::SchedulingPhase::Tick, 0
};数据会在当前 Tick 的 Tick 阶段立即送达接收方回调。这极其适合表达周期内的反压信号或 Credit 返还。
致命陷阱(0-cycle 组合循环): 若模块 A 在 Tick 阶段收到 0-cycle 数据并触发回调,该回调又通过 0-cycle Port 立即向模块 B 发送响应;模块 B 的回调若又无条件反向发回模块 A,Scheduler 将在当前 Tick 内不断追加新事件,导致仿真器死锁在同一个 TickQuantum 中无法推进。
要打破 0-cycle 反馈环,模型必须满足以下三个条件之一:
- 状态守恒截断: 回调仅更新内部计数(如 Credit 累加)或进行有上限的状态标记,不无条件连环重发;
- 时序延迟引入: 前向数据采用 1-cycle(经由
PortUpdate交付),仅反向握手采用 0-cycle; - DAG 依赖固化: 显式约束阶段内优先次序,阻止递归触发。
7. 静态结构检查与端到端事务追踪#
在阅读陌生模型源码时,盲目阅读 .cpp 容易迷失在细节中。利用继承自 sparta::app::CommandLineSimulator 的标准工具链,可以在不实际跑 workload 的情况下直接导出模型的静态骨架:
# 查看仿真器支持的全部命令行参数
./simulator --help

# 1. 导出完整模型树(确认有哪些 ResourceTreeNode 与 Unit 挂载)
./simulator --show-tree --no-run > tree.txt

# 2. 导出所有参数及其最终取值(定位配置项)
./simulator --show-parameters --no-run > parameters.txt

# 3. 导出所有已完成绑定的 Port 连接关系(验证拓扑方向)
./simulator --show-ports --no-run > ports.txt

# 4. 导出同 Phase 事件的 DAG 拓扑图(核验显式 precedence)
./simulator --show-dag --no-run > dag.txt

# 5. 导出时钟域层次与各模块 Period
./simulator --show-clocks --no-run > clocks.txt

# 6. 将合并命令行覆盖后的最终有效参数导出为 YAML
./simulator --write-final-config final.yaml --no-run
结合这些结构文件,读者可以沿任一业务事务建立纵向追踪链路:
[Input DataPort] (查 ports.txt 确认上游来源与 delay)
       ↓
[InPort Handler] (在 Unit 源码中查找回调,确认在 PortUpdate 还是 Tick)
       ↓
[Buffer / State Check] (检查是否更新本地队列或扣减 Credit)
       ↓
[Internal Event] (检查是否调用 schedule(delay),确认目标 Clock 与 Phase)
       ↓
[Output DataPort] (调用 send() 发放下游,确认下游接收时钟域)在记录时序结论时,每一个断言必须具备完整的四维坐标:时钟域(Clock)、周期(Cycle/Tick)、阶段(Phase)与优先级(Precedence)。
8. 源码阅读心智总结#
理解 SPARTA 的离散事件运行机制,核心在于将任何代码操作落实在时间契约中:
- 资源与配置分离: 在
buildTree_()阶段只建立树节点与参数集,待配置固化进入 Finalize 后才实例化真正的业务 Resource。 - 时间与事件解耦: 全局时间以
Tick推进,模块操作以Cycle计算;没有事件的区间被调度器自然跨越。 - 阶段划分边界:
PortUpdate负责 N-cycle 端口交付,Tick负责核心处理与 0-cycle 交互;同一阶段内的先后依赖必须由 DAG Precedence 显式固化。
掌握了这一套从 Tick 到 Port 的四维运行机制,阅读上层性能模型(如流水线、缓存系统或互联网络)时,代码的执行逻辑将不再是一团模糊的回调网络,而是一条条因果明确、时钟对齐的确定性事件序列。
证据边界与未验证说明#
- 核心机制基于公开 MAP 源码(Commit
9d8ec03c0e118820e1093831b9060d8d17164d8d,2026-08-23 验证)中的Scheduler、Clock、SchedulingPhases、DataPort以及SkeletonPipeline示例实现。 - 本文未包含或引用任何特定商业处理器的专有拓扑、私有流水线结构或实际基准性能数据。
- 命令行导出能力依据
sparta::app::CommandLineSimulator源码分析归纳;因当前测试工作区未预装yaml-cpp开发包,未在本地执行编译,文中未伪造动态终端运行输出。不同上层仿真器可能在派生时裁剪或重写部分 CLI 选项,读者应始终以具体仿真器的./simulator --help输出为准。
本文采用 CC BY-NC-SA 4.0 许可。