阅读信息
- 内容类型:解释
- 难度:中级
- 适合谁:已理解 SPARTA Port 时序、正在阅读带队列和反压模型的架构工程师。
- 读完后:读完后,读者能够沿 Fetch↔Decode 的具体源码解释 Instruction 与 Credit 的双向闭环,并用容量守恒检查一个 SPARTA backpressure 实现是否正确。
- 依据版本:MAP 9d8ec03c0e118820e1093831b9060d8d17164d8d
- 验证日期:2026-08-24
假设 Decode 模块的输入队列当前还剩 3 个空闲槽位,上游 Fetch 模块能不能立刻发送 3 条新指令?
在基于 Credit 的微架构协议中,答案不是“先发过去看看会不会被拒绝”,而是:Fetch 必须在本地预先持有至少 3 枚由 Decode 授予的 Credit 凭证。
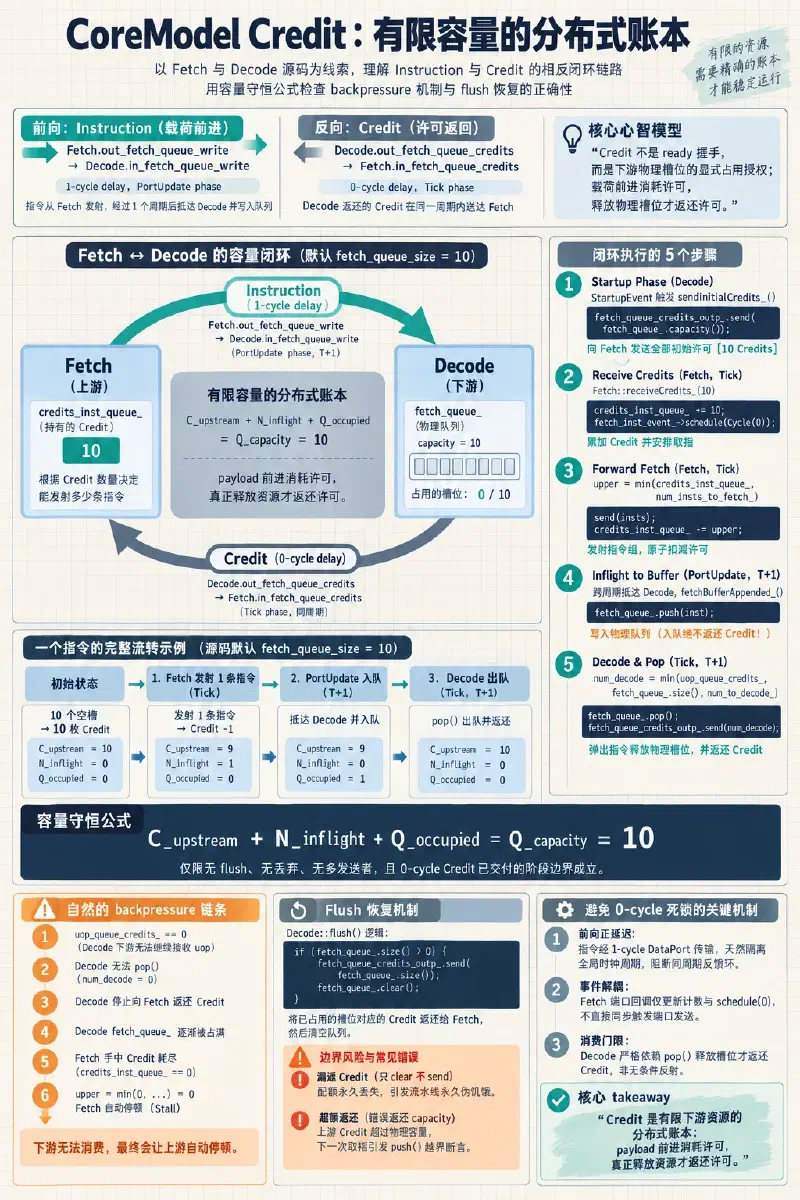
这就是 Credit(信用/令牌)机制的核心心智模型:它不是模糊的布尔型 ready 握手电平,也不是已经发射的指令负载;每一枚 Credit 代表下游对一个特定有限物理槽位(Queue Slot)的明确占用授权。 指令载荷向前流动消耗授权,下游真正消化数据释放物理槽位后,空闲许可再以反向 Credit 的形式返还上游。
本文聚焦公开示例 sparta/example/CoreModel 中的 Fetch 与 Decode 交互链路。通过剖析其真实源码,拆解 Credit 从何而来、何时扣减、何时返还,推导容量守恒公式,并解释为什么 0-cycle Credit 不会在离散事件引擎中诱发无限反馈死锁。
1. 物理拓扑:双向通道与分布式容量账本#
在 sparta/example/CoreModel/src/CPUTopology.cpp 中,Fetch 与 Decode 之间建立了两个反向绑定的端口对 [SRC]:
两个端点的参数与属性声明如下:
| 端口名称 | 所属模块 | 方向与延迟 | 调度阶段 | 传输数据类型 | 核心语义 |
|---|---|---|---|---|---|
out_fetch_queue_write | Fetch | OutPort | - | InstGroup | 发送一组已取出的指令 |
in_fetch_queue_write | Decode | InPort, 1 cycle | PortUpdate | InstGroup | 指令写入 Decode 缓冲区 |
out_fetch_queue_credits | Decode | OutPort | - | uint32_t | 返还释放的空闲槽位数量 |
in_fetch_queue_credits | Fetch | InPort, 0 cycle | Tick | uint32_t | 接收可用 Credit 增量 |
Decode 内部的接收队列 fetch_queue_ 容量由参数 fetch_queue_size 决定(源码默认值为 10)。Fetch 既不能直接读取 Decode 内部队列的实时指针,也无法调用 Decode 的私有函数。Fetch 仅依靠内部维护的整型变量 credits_inst_queue_,实现对下游可用物理容量的镜像同步。
容量守恒不变量#
在一个闭环运行的 Credit 系统中,当下游无 flush、无丢弃且零周期传输已完成的阶段边界上,全系统容量必须严格满足如下守恒等式:
$$ C_{\text{upstream}} + N_{\text{inflight}} + Q_{\text{occupied}} = Q_{\text{capacity}} $$- \(C_{\text{upstream}}\):Fetch 当前手头持有、尚未消耗的可用 Credit 计数;
- \(N_{\text{inflight}}\):Fetch 已发出、扣除了 Credit,但因跨周期端口延迟仍在空中传输的指令数量;
- \(Q_{\text{occupied}}\):已进入 Decode 且尚未被
pop()弹出的指令数量(即fetch_queue_.size()); - \(Q_{\text{capacity}}\):Decode 队列物理上限总容量(即
fetch_queue_.capacity())。
这套算式是审查任何反压模型的金标准:无论仿真推进到哪一个 Tick,只要指令未被消费或丢失,整个流水线中的许可与载荷总和恒等于物理缓冲区容量。
2. 初始状态:Decode 在 Startup 时签发首批许可证#
系统刚完成构造时,Fetch 本地的 credits_inst_queue_ 初始化为 0。如果此时没有任何一方主动通报容量,Fetch 将陷入无许可可用的死锁状态。
打破僵局的关键是 Decode 的 StartupEvent。在 Decode::Decode() 构造函数中注册了启动回调 [SRC]:
sparta::StartupEvent(
    node,
    CREATE_SPARTA_HANDLER(Decode, sendInitialCredits_));

void Decode::sendInitialCredits_()
{
    // 向 Fetch 一次性授予全部空闲槽位的许可
    fetch_queue_credits_outp_.send(fetch_queue_.capacity());
}
在仿真主时钟推进前的 Startup 阶段,Decode 一次性将 fetch_queue_.capacity()(如 10)作为初始 Credit 发出。
Fetch 端的接收端口声明表明,它属于 0-cycle、Tick 阶段:
sparta::DataInPort<uint32_t> in_fetch_queue_credits_ {
    &unit_port_set_,
    "in_fetch_queue_credits",
    sparta::SchedulingPhase::Tick,
    0
};
当该端口收到 10 枚 Credit 时,触发回调 receiveCredits_():
void Fetch::receiveCredits_(const uint32_t & credits)
{
    credits_inst_queue_ += credits; // 记账:可用槽位增加
    // 立即唤醒取指事件,安排在当前周期的 Tick 阶段执行
    fetch_inst_event_->schedule(sparta::Clock::Cycle(0));
}
注意其职责边界:端口回调仅执行纯粹的状态记账与事件唤醒,并不直接在回调内同步构造或发送指令。真正的取指工作留给由 Scheduler 管理的 fetch_inst_event_。
3. 前向发射:Fetch 先扣除 Credit,载荷进入 1-cycle 通道#
当 fetch_inst_event_ 触发执行 fetchInsts_() 时,Fetch 计算当前周期允许发射的指令上限:
// 发射量受限于当前持有的 Credit 与单周期最大取指宽度
const uint32_t upper = std::min(credits_inst_queue_, num_insts_to_fetch_);

if (upper > 0) {
    InstGroup insts_to_send = getNextInstGroup_(upper);
    out_fetch_queue_write_.send(insts_to_send);
    credits_inst_queue_ -= upper; // 原子扣除本地授权凭证
}
一旦 send() 被调用,对应的 \(upper\) 个许可立即从 \(C_{\text{upstream}}\) 扣减并转变为 \(N_{\text{inflight}}\)(在途飞行)。
由于 Decode 的输入端口 in_fetch_queue_write 声明了 1 cycle 延迟:
sparta::DataInPort<InstGroup> fetch_queue_write_in_ {
    &unit_port_set_,
    "in_fetch_queue_write",
    1 // 1 cycle delay
};
因此在整个周期内,这笔指令既不在 Fetch 的可用许可账本中,也尚未写入 Decode 的物理队列。如果此时外部检查守恒式,在途项 \(N_{\text{inflight}}\) 恰好等于 \(upper\),总和严格不变。
4. 消费与反压:Decode 的双重约束与出队返还#
在 Tick \(T+1\) 的 PortUpdate 阶段,指令载荷抵达 Decode 并触发 fetchBufferAppended_():
void Decode::fetchBufferAppended_(const InstGroup & insts)
{
    for (auto & inst : insts) {
        fetch_queue_.push(inst); // 写入物理队列
    }
    // 若下游(Rename)有可用容量,唤醒解码事件
    if (uop_queue_credits_ > 0) {
        ev_decode_insts_event_.schedule(sparta::Clock::Cycle(0));
    }
}
此时指令从 \(N_{\text{inflight}}\) 正式转入 \(Q_{\text{occupied}}\)。注意:入队动作绝不返还 Credit! 此时槽位仍处于被占用状态。
在同周期的 Tick 阶段,decodeInsts_() 尝试进行解码。它的处理吞吐受到三重限制:
// 1. 下游 Rename 阶段允许接收的微操作 Credit
uint32_t num_decode = std::min(uop_queue_credits_, fetch_queue_.size());
// 2. 本模块每周期最大解码宽度
num_decode = std::min(num_decode, num_to_decode_);

if (num_decode > 0) {
    for (uint32_t i = 0; i < num_decode; ++i) {
        auto inst = fetch_queue_.pop(); // 真正弹出并处理指令
        sendToRename_(inst);
    }
    // 关键:只有真正出队释放了物理槽位,才向 Fetch 返还对应数量的 Credit
    fetch_queue_credits_outp_.send(num_decode);
    uop_queue_credits_ -= num_decode;
}反压机制的自然形成#
当后端发生结构停顿(如 ROB 满或 Execution Unit 阻塞),Rename 停止向 Decode 发放 Credit(uop_queue_credits_ == 0):
- Decode 的
decodeInsts_()无法弹出指令,num_decode = 0; - Decode 停止向 Fetch 返还 Credit;
- Fetch 在连续取指若干周期后,本地
credits_inst_queue_彻底归零; - Fetch 的
upper = std::min(0, num_insts_to_fetch_) = 0,自动停顿(Stall),不再发送新指令。
无需任何额外的跨模块停顿信号,仅通过 Credit 扣竭,反压就自然沿着流水线逆向蔓延。
5. 为什么 0-cycle Credit 不会产生无限调度循环#
初读 SPARTA 端口代码时,一个极易产生的担忧是:
“Fetch 收到 0-cycle Credit 在同周期执行,若它发出的请求又立即让 Decode 消费并返还 0-cycle Credit,两者岂不是在同一 Tick 内死循环?”
在 CoreModel 中,这种无限循环被三重结构性机制彻底打破:
- 前向正延迟隔离: Fetch 发送的指令通过 1-cycle 延迟端口写入 Decode。这意味着前向信号必须消耗全局逻辑时间推进(到下一个 Tick 的
PortUpdate阶段),天然截断了同周期的组合环路。 - 事件分工解耦: Fetch 收到 0-cycle Credit 时,回调仅执行
+= credits并调用schedule(Cycle(0))。回调内部不直接同步触发端口发送。 - 消费条件门限: Decode 返还 Credit 严格依赖于
fetch_queue_.pop(),而弹出操作受制于下游 Credit 与解码带宽,并非收到数据就反射性返还。
因此,这里的 0-cycle 仅表示“一旦下游释放槽位,上游在同一周期内便能感知到该许可”,从而允许上游在下一个可用时钟沿无缝填补空缺,消除了额外的气泡周期(Bubble)。
6. 异常与冲刷:Flush 必须恢复容量账本#
当处理器遇到分支预测错误或异常时,流水线必须执行冲刷(Pipeline Flush)。在 Decode::flush() 中,源码执行了如下关键操作 [SRC]:
void Decode::flush()
{
    if (fetch_queue_.size() > 0) {
        // 将被废弃的指令所占用的槽位数量,以 Credit 形式返还给 Fetch
        fetch_queue_credits_outp_.send(fetch_queue_.size());
        fetch_queue_.clear(); // 清空物理队列
    }
}
这一处理展示了 Credit 协议中最具陷阱的边界条件:
- 致命缺陷 A(漏返 Credit): 若代码仅执行
fetch_queue_.clear()而忘记发送 Credit,Fetch 的credits_inst_queue_将永久丢失这部分配额。随着多次 Flush,Fetch 手中的 Credit 逐渐耗尽,最终导致整个流水线因伪饥饿而永久挂起。 - 致命缺陷 B(超额返还): 若返还的数量大于实际清空的指令数(例如错误地发送了
fetch_queue_.capacity()),上游持有的 Credit 将超过实际物理容量,下一次大量取指涌入时将直接击穿队列上限,引发push()越界断言。
7. 审查 Credit 与反压模型的实用清单#
在阅读其他模块(如 Load/Store Queue、NoC Router 或 Execution Reservation Station)的 Credit 机制时,建议使用以下清单对照审查源码:
| 检查项 | 关键定位点 | 源码审查问题 | 典型失效模式 |
|---|---|---|---|
| 1. 物理容量定义 | Unit 构造与 ParameterSet | 接收队列容量是否为确定值?参数修改后队列是否同步重构? | 队列固定数组大小与参数不一致,导致溢出 |
| 2. 初始 Credit 注入 | StartupEvent 回调 | 是否由且仅由接收方在 Startup 时刻发送?发送量是否严格等于队列容量? | 遗漏 Startup 发送导致上游永远等待;或多处重复初始化导致超发 |
| 3. 扣减原子性 | 发送端 send() 路径 | 扣除计数是否与实际送出的 payload 数量完全一致? | 提前扣减但在发送失败时未回退,导致 Credit 泄露 |
| 4. 返还时机 | 接收端 pop() / Retire 路径 | 是否在数据真正移出缓冲区、物理槽位空出时才返还? | 在入队(append)时就提前返还,失去背压保护能力 |
| 5. Flush 恢复 | Flush / Cancel / Retry 逻辑 | 冲刷时是否准确返还了被丢弃的元素数量? | 丢弃数据未还 Credit 导致流水线饿死;全额返还导致容量击穿 |
| 6. 环路终止性 | Port delay 与 Callback | 若两端均存在 0-cycle 交互,是否存在非受控递归? | 同周期无限反射导致 Scheduler 死锁在当前 Tick |
8. 总结:Credit 是微架构流控的分布式契约#
在 SPARTA 性能模型中,Credit 机制的本质是将集中式的队列状态转化为分布式的许可证账本:
- 下游掌管物理实体: 下游拥有真实的队列存储,是容量的签发者与终极回收者。
- 上游依据授权行动: 上游仅持有镜像计数,没有许可便自我制动。
- 端口决定感知时机: 0-cycle 使得释放槽位的收益能够即刻对齐到当前周期,而正向的数据延迟保证因果链条不会退化为组合死循环。
通过容量守恒等式与 Flush 恢复审计,架构工程师可以快速穿透纷繁复杂的端口绑定,严密验证任何微架构反压设计的正确性与鲁棒性。
证据边界与未验证说明#
- 技术分析与代码段基于公开 MAP 源码快照(Commit
9d8ec03c0e118820e1093831b9060d8d17164d8d,2026-08-24 验证),主要来自sparta/example/CoreModel/src/Fetch.*、Decode.*与CPUTopology.cpp。 - 本文仅聚焦 Fetch 与 Decode 之间的点对点 Credit 闭环,未展开 CoreModel 后续 Rename、ROB 及 Memory 层次结构的复杂仲裁逻辑。
- 本地环境未独立编译 CoreModel 二进制,文中的时序推导与守恒推论完全基于源码静态控制流与数据流审计。不同仿真器上层实现若引入动态 Credit 聚合或可变包长,应相应扩展守恒等式。
本文采用 CC BY-NC-SA 4.0 许可。