阅读信息
- 内容类型:解释
- 难度:中级
- 依据版本:MAP 9d8ec03c0e118820e1093831b9060d8d17164d8d
- 验证日期:2026-08-24
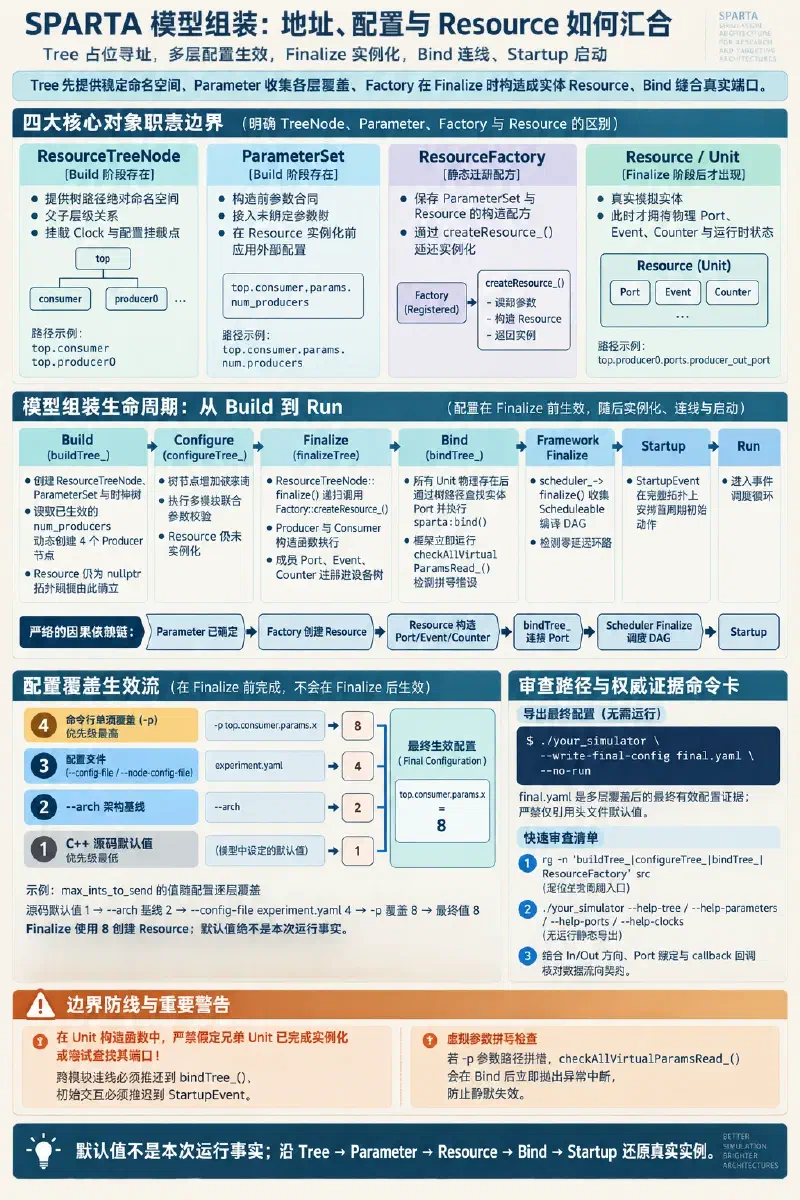
在 SkeletonSimulator::buildTree_() 中,代码已经能从 Consumer 的 ParameterSet 读取 num_producers,但注释又明确指出此时 Consumer 对象尚未创建。这并不矛盾:SPARTA 先建立“模型将来放在哪里、可以怎样配置”的设备树节点,再根据最终参数实例化真正运行的 Resource。
这个先后关系是读懂 MAP/SPARTA 模型的入口。若把 ResourceTreeNode 当成 Unit 本身,就很难解释配置为什么能在构造 Resource 之前改变拓扑,也很难判断源码默认值、YAML 配置文件与命令行 -p 覆盖中究竟哪个值最终生效。
本文沿固定提交 9d8ec03c 中的 SkeletonPipeline 走完一次模型组装的完整生命周期:注册 Factory、创建节点、虚拟参数匹配、Finalization 实例化、绑定 Port、调度器 DAG 冻结,最后进入 Startup 与 Run。读完后,你应该能够从一个 Tree path 找到它的参数、实际 Resource 和端口,并知道怎样导出最终配置核对自己的判断。
1. Tree 先描述模型的地址和边界#
SPARTA 的 Tree 不只是为了打印层级。一个节点在设备树中的绝对路径,会同时作为参数匹配、端口查找、Logger tap、Report 挂载和运行时调试的统一寻址空间。例如:
top
├── consumer
│   ├── params
│   ├── ports
│   └── stats
└── producer0
    ├── params
    ├── ports
    └── stats
其中 top.consumer.params.num_producers 是可配置参数的完整路径,top.producer0.ports.producer_out_port 是端口绑定时查找端口对象的路径。节点位置把“配置作用到谁”和“观察谁的行为”统一在同一套树状命名空间里。
TreeNode 负责最一般的父子层级关系;ResourceTreeNode 则是将来承载具体模拟组件(Resource)的专用节点。当前源码对它的定义很明确:一个 ResourceTreeNode 包含一个 ResourceFactory、一个 ParameterSet,并关联一个 Clock;进入 Finalized 阶段后,它才包含由这些参数构造出来的实际 Resource 对象。[SRC]
因此,在模型构建过程中,下面两句话必须同时成立:
- Build 阶段:已经存在
top.consumer这个设备树位置与对应的ParameterSet; - Build 阶段:还不存在可接收数据、拥有运行状态的
ConsumerUnit 实例。
前者让框架能够在完整路径上提前匹配并应用来自命令行和配置文件的参数;后者保证最终 Resource 使用配置完成后的最新数值进行构造。
2. Factory 是配方,ParameterSet 是构造前合同#
在 SkeletonSimulator 构造函数中,首先注册的是工厂:
SkeletonSimulator::SkeletonSimulator(sparta::Scheduler & scheduler, bool be_noisy) :
    sparta::app::Simulation("sparta_skeleton", &scheduler),
    be_noisy_(be_noisy)
{
    // 将所有资源工厂注册到 ResourceSet 中,此时尚未创建任何模拟对象
    getResourceSet()->addResourceFactory<
        sparta::ResourceFactory<Producer, ProducerParameterSet>>();
    getResourceSet()->addResourceFactory<
        sparta::ResourceFactory<Consumer, Consumer::ConsumerParameterSet>>();
}
这里没有创建任何 Producer 或 Consumer 实例。ResourceFactory 保存的是两类关键信息:如何创建与该 Resource 绑定的 ParameterSet,以及如何在后续阶段传入节点指针与参数对象来构造真正的 Resource。
随后,框架调用 buildTree_(),代码创建 Consumer 的 ResourceTreeNode,并立即读取其参数:
void SkeletonSimulator::buildTree_()
{
    // 创建 Consumer 对应的 ResourceTreeNode,Factory 会同步为其创建 params 子节点
    sparta::ResourceTreeNode* rtn =
        new sparta::ResourceTreeNode(getRoot(), "consumer",
                                     sparta::TreeNode::GROUP_NAME_NONE,
                                     sparta::TreeNode::GROUP_IDX_NONE,
                                     "Consumer Object",
                                     getResourceSet()->getResourceFactory(Consumer::name));
    to_delete_.emplace_back(rtn);

    // 从已挂载的 ParameterSet 中读取 num_producers
    // 此时 Consumer Unit 尚未实例化!
    sparta::ParameterSet * param_set = rtn->getParameterSet();
    const uint32_t num_producers =
        param_set->getParameterAs<uint32_t>("num_producers");

    // 根据配置的生产者数量,动态创建对应数量的 producer 节点
    for (uint32_t i = 0; i < num_producers; ++i)
    {
        std::stringstream nodeName, humanName;
        nodeName << "producer" << i;
        humanName << "Producer " << i;

        sparta::ResourceTreeNode* prod_tn =
            new sparta::ResourceTreeNode(getRoot(),
                                         nodeName.str(),
                                         "producer", i,
                                         humanName.str(),
                                         getResourceSet()->getResourceFactory(Producer::name));
        to_delete_.emplace_back(prod_tn);
    }
}读者常有的疑问是:如果 Consumer 尚未构造,param_set 里的 num_producers 为什么能反映命令行 -p 或配置文件中的覆盖值?
原因在于 CommandLineSimulator::populateSimulation_() 的调用顺序:
- 在调用
buildTree()之前,框架已调用sim->configure(),将命令行参数、YAML 配置文件解析并合成为内部的“未绑定参数树”(UnboundParameterTree); - 当
ResourceTreeNode构造并挂载到根节点时,ParameterSet会自动连接到模拟器的未绑定参数树,并在节点接入时执行readValuesFromVirtualTree_(); - 因此,在
buildTree_()刚创建完rtn之后读取num_producers,拿到的是已经完成覆盖的有效参数。[SRC]
这展示了 SPARTA 中 Parameter 的核心能力:它不仅改变 Resource 的内部逻辑(如队列深度、发送上限),还能直接决定拓扑规模与子节点创建。若 num_producers=4,Build 阶段会生成四个 Producer 节点;如果等到 Resource 构造完成再去读取参数,就无法动态改变树结构了。
三者的职责边界可以总结为:
| 对象 | Build 阶段是否存在 | 主要职责 |
|---|---|---|
ResourceTreeNode | 是 | 提供树路径、父子关系、关联 Clock,并作为配置与调试的挂载点 |
ParameterSet | 是 | 作为构造合同,保存并在 Resource 实例化前应用外部配置 |
Resource / Unit | 否 | 模拟逻辑实体,拥有 Port、Event、Counter 与运行时状态 |
3. 一次完整组装经历哪些阶段#
SPARTA 模型的组装由 sparta::app::Simulation 与 CommandLineSimulator 严格约束为受控的阶段流:
1. Simulation::configure()
   解析 CLI、--arch、YAML 配置文件,构建虚拟 UnboundParameterTree

2. Simulation::buildTree() -> buildTree_()
   创建 ResourceTreeNode 占位节点;根据已生效参数动态构建拓扑规模

3. Simulation::configureTree() -> configureTree_()
   设备树冻结增加节点;模型可在此执行特殊的参数修正或联动检查

4. Simulation::finalizeTree()
   ├── root_.enterFinalized()
   │   遍历所有 ResourceTreeNode,调用 ResourceFactory::createResource_()
   │   真实 Unit 构造:内部的 Port、Event、Counter、Logger 实例化并注册
   ├── bindTree_()
   │   在所有 Unit 存在的前提下,通过树路径查找 Port 并调用 sparta::bind()
   ├── checkAllVirtualParamsRead_()
   │   核验所有 CLI / YAML 传入的参数是否都被实际消费(拼写错误在此报错)
   └── root_.validatePreRun()
       检查必要端口是否均已完成有效绑定

5. Simulation::finalizeFramework()
   Scheduler 遍历所有 Scheduleable 编译 DAG,检测零延迟环路与依赖合法性

6. Simulation::run()
触发 StartupEvent 安排首个周期的初始动作,进入事件调度循环Build:创建稳定的地址空间与结构规模#
buildTree_() 负责创建所有的 ResourceTreeNode、纯组织层级的 TreeNode 以及时钟层次结构。此时根节点处于 TREE_BUILDING 状态。模型允许读取已挂载节点的 ParameterSet 来决定后续节点数量,但严禁尝试访问兄弟节点的 Resource 实例(此时指针仍为 nullptr)。
Configure:模型特定的配置联动#
在进入 configureTree_() 前,根节点进入 TREE_CONFIGURING 阶段,框架禁止继续向树中添加新的 ResourceTreeNode。SkeletonPipeline 在此阶段没有额外逻辑,但复杂模型可以在此 hook 中根据多模块联合参数进行二次校验。此时 Resource 仍然未被实例化。[SRC]
Finalize:用最终参数创建 Resource#
Simulation::finalizeTree() 将整棵树推进至 TREE_FINALIZED。
root_.enterFinalized() 递归访问所有 ResourceTreeNode,调用对应的 ResourceFactory::createResource_()。只有进入这个时刻:
- 参数的依赖校验回调(如 Producer 的
non_zero_validator)执行; Producer与Consumer的构造函数执行;- 挂载在
unit_port_set_、unit_event_set_、unit_stat_set_下的实际Port、Event和Counter才会真正注册到树中。[SRC]
Bind:把路径解析成真实通信关系#
在 finalizeTree() 内部、enterFinalized() 之后,框架调用子类实现的 bindTree_()。SkeletonPipeline 在此时通过完整路径解析端口并建立连接:
void SkeletonSimulator::bindTree_()
{
    sparta::TreeNode* root_tree_node = getRoot();
    sparta_assert(root_tree_node != nullptr);

    sparta::ParameterSet * param_set =
        root_tree_node->getChildAs<sparta::ParameterSet>("consumer.params");
    const uint32_t num_producers =
        param_set->getParameterAs<uint32_t>("num_producers");

    for (uint32_t i = 0; i < num_producers; ++i)
    {
        std::stringstream nodeName;
        nodeName << "producer" << i;

        // 将每个 producer 的 out port 绑定到 consumer 的 in port
        sparta::bind(root_tree_node->getChildAs<sparta::Port>(
                         nodeName.str() + ".ports.producer_out_port"),
                     root_tree_node->getChildAs<sparta::Port>(
                         "consumer.ports.consumer_in_port"));

        // 将 consumer 为该 producer 分配的专属 go port 绑定到 producer 的 go port
        sparta::bind(root_tree_node->getChildAs<sparta::Port>(
                         nodeName.str() + ".ports.producer_go_port"),
                     root_tree_node->getChildAs<sparta::Port>(
                         "consumer.ports." + nodeName.str() + "_go_port"));
    }
}
如果在 bindTree_() 中路径拼错、端口方向不合法(例如两个 InPort 相连),或者参数未生成对应的 Producer 节点,getChildAs<sparta::Port> 或 sparta::bind() 会当场抛出 SpartaException,在仿真启动前彻底暴露结构问题。
绑定完成后,框架立即执行 checkAllVirtualParamsRead_()。如果你在命令行输入了 -p top.consumer.params.misspelled_param=10,框架在此处会发现该参数未被任何 ParameterSet 消费,直接抛出异常中断运行,防止配置静默失效。
Framework Finalize 与 Startup#
端口绑定与静态校验通过后,finalizeFramework() 调用 scheduler_->finalize()。Scheduler 收集所有事件与端口间的先后依赖建立有向图,如果存在依赖死锁或零延迟环路,抛出 sparta::DAG::CycleException。
一切就绪后,run() 触发 StartupEvent。SkeletonPipeline 的 Consumer 通过初始事件向 Producer 发送首个 go 信号,随后驱动整个事件流运转。
4. 最终参数来自哪一层#
在实际工程中,只查看 C++ 头文件中的参数声明默认值是极不可靠的。CommandLineSimulator 严格按以下优先级自底向上进行参数覆盖:
第 1 层:C++ 源码默认值
        PARAMETER(uint32_t, max_ints_to_send, 100, "Send a bunch of ints")
        ↓
第 2 层:架构基线(Architecture Baseline)
        --arch <arch_name> (读取基线 YAML,建立成套微架构默认值)
        ↓
第 3 层:配置文件与节点配置
        --config-file <global.yaml> / --node-config-file <path> <node.yaml>
        ↓
第 4 层:命令行单项显式覆盖
        -p top.producer0.params.max_ints_to_send=500
        ↓
生效结果:Final Configuration
以 max_ints_to_send 为例:
- 源码默认值为
100; --arch high_throughput可能将其基准重置为1000;- 实验配置文件
experiment.yaml将其设置为200; - 启动脚本追加
-p top.producer0.params.max_ints_to_send=50; - 最终实际生效值确定为
50。
--arch 适合定义一套微架构基线;--config-file 适合描述一次完整的测试负载或实验配置;-p 只适合调试时注入极少量的定向覆盖。把几十个参数全部平铺在命令行 -p 中会严重破坏实验的可复现性与审计追踪。
最确定且权威的核验手段是在运行前导出最终配置:
# 导出本次运行完全解析后的所有参数值,并阻止进入仿真运行
./your_simulator \
  --write-final-config final.yaml \
  --no-run
若需要核对参数的字段描述、数据类型与取值范围,可使用详细导出格式:
./your_simulator \
  --write-final-config-verbose final-verbose.yaml \
  --no-run
在撰写架构分析报告或提交实验复盘时,参数取值必须以导出的 final.yaml 为依据,而不能仅引用头文件中的默认数值。[SRC]
5. 为什么绑定必须发生在 Finalize 之后#
在 SPARTA 中,Port 是实际 Unit 的 C++ 成员变量(例如 Consumer 内部的 consumer_in_port_),而不是 ResourceTreeNode 上的抽象字符串占位符。
class Consumer : public sparta::Unit
{
    // ...
    // consumer_in_port_ 是 Consumer 实例的成员变量
    sparta::DataInPort<uint32_t> consumer_in_port_{&unit_port_set_, "consumer_in_port", 1};
    // 动态生成的 go 端口也是运行时由 unique_ptr 管理的实体
    std::vector<std::unique_ptr<sparta::SignalOutPort>> producer_go_port_;
};
在 buildTree_() 期间,Consumer 对象尚未实例化,内存中根本不存在 consumer_in_port_ 的物理对象,树中也没有 consumer.ports 这一子分支。如果此时尝试执行 sparta::bind(),通过树查找端口必然返回空指针引发异常。
正确的依赖关系链必须是:
ParameterSet 确定最终配置数值
    ↓
ResourceTreeNode::finalize() 调用 Factory::createResource_()
    ↓
Resource (Unit) 构造,其内部成员 Port / Event / Counter 完成注册
    ↓
Simulation::bindTree_() 通过路径查找实体 Port 并建立连接
    ↓
Scheduler::finalize() 冻结调度图并编译 DAG
    ↓
StartupEvent 安排首个 Tick 的初始动作这一生命周期规定也确立了一条重要的编写原则:在 Unit 的构造函数中,绝对不能假设相邻或兄弟 Unit 已经实例化完成。 Unit 构造函数仅用于初始化自身的数据结构、注册本模块的端口、事件与统计计数器;跨模块的连接属于拓扑层面的 bindTree_();需要访问兄弟节点或发送初始请求的逻辑,必须推迟到 StartupEvent 中执行。
6. 怎样审查一个模型是如何被组装的#
面对一个陌生的 SPARTA 模型,可按以下标准步骤进行无猜测的结构核验:
第一步:定位仿真边界与组装入口#
从 main() 入手,找到 CommandLineSimulator 实例以及继承自 sparta::app::Simulation 的核心模拟器类,使用文本搜索快速定位关键生命周期函数:
rg -n 'buildTree_|configureTree_|bindTree_|ResourceFactory' src理清代码在哪个文件注册了 Factory,在哪个文件实现了树的构建与连线,不要一开始就深入某个数百行的具体 Unit 内部。
第二步:识别拓扑参数与依赖节点#
阅读 buildTree_() 实现,记录哪些参数控制了子节点的生成逻辑(例如类似 num_producers、num_cores、num_l2_banks 的参数),确认各节点所关联的 Clock 域以及所使用的 ResourceFactory。
第三步:导出无运行静态结构#
利用 CommandLineSimulator 提供的标准自省入口,在不运行实际负载的前提下导出设备树信息:
./your_simulator --help-tree       > tree.txt
./your_simulator --help-parameters > parameters.txt
./your_simulator --help-ports      > ports.txt
./your_simulator --help-clocks     > clocks.txt
这些 --help-* 选项内部均隐式启用了 --no-run,适合在避免硬件副作用或工作负载依赖的情况下快速获取完整的结构证据。[SRC]
第四步:对比配置来源并核验最终值#
比对源码声明默认值、架构基线与命令行传参。若三者存在差异,核查导出的 final.yaml。当发现参数未生效时,按顺序排查:
- 节点路径(Tree path)拼写是否准确;
- 参数是否被后续的 YAML 文件或
-p静默覆盖; - 该参数是否在
buildTree_()期间被正确读取并传递给对应组件。
第五步:核对端口绑定契约#
通过 ports.txt 检查端口是否成功导出并完成绑定。结合头文件中的 DataInPort / DataOutPort 泛型类型、delay 数值以及接收回调函数,建立准确的数据流向结论。严禁单纯依赖端口名中的 req、rsp 或 credit 来推断其通信协议与周期延迟。
7. 一个可复用的心智模型#
SPARTA 的模型组装机制可以凝练为一条核心法则:
Tree 先提供稳定命名空间,Parameter 在命名空间中收集各层覆盖,Factory 在 Finalize 时把最终参数构造成实体 Resource,Bind 在 Resource 存在后将其端口缝合成完整网络。
当配置与预期运行行为不符时,沿以下五个关卡逐级回溯:
- 寻址有效性:目标节点的树路径是否存在?参数名称是否匹配?
- 覆盖优先级:哪一层配置(源码默认、
--arch、配置文件、-p)最终决定了该参数? - 实例化生效:Finalize 是否根据最终参数创建了对应规模与属性的 Resource?
- 端口互联:
bindTree_()是否成功将实体端口连接?是否存在未绑定悬空端口? - 调度起步:Startup 是否在连接完成的网络上安排了合理的初始事件?
下一篇将探讨模型组装完成之后的时序与调度核心:当多个 Port 回调与 Event 同时落在同一个 Tick 时,SPARTA 究竟如何利用 Phase 与 DAG 消除执行顺序的偶然性。
本文采用 CC BY-NC-SA 4.0 许可。