阅读信息
- 内容类型:解释
- 难度:中级
- 依据版本:MAP 9d8ec03c0e118820e1093831b9060d8d17164d8d
- 验证日期:2026-08-24
假设两个延时为 1 个周期的 DataPort 在 Cycle 20 同时到达同一个接收模块,两个接收回调函数都在内部调用了 event.schedule()(未指定 delay,即 delay 为 0)。这个处理事件会不会在第一个回调执行后立即触发,从而导致它读取状态时发现第二份数据尚未到达?
在 SPARTA 框架中,这种情况绝不会发生。正延时(delay > 0)的 DataPort 其投递回调被硬性划分在 PortUpdate 阶段,而普通的 Event 默认属于 Tick 阶段。调度器在当前逻辑 Tick 内,必然先彻底执行完该 Tick 的所有 PortUpdate 阶段工作,随后才进入 Tick 阶段。因此,两个端口的回调函数都有充分机会保存各自的数据负载,随后 Tick 阶段的事件才会统一执行。
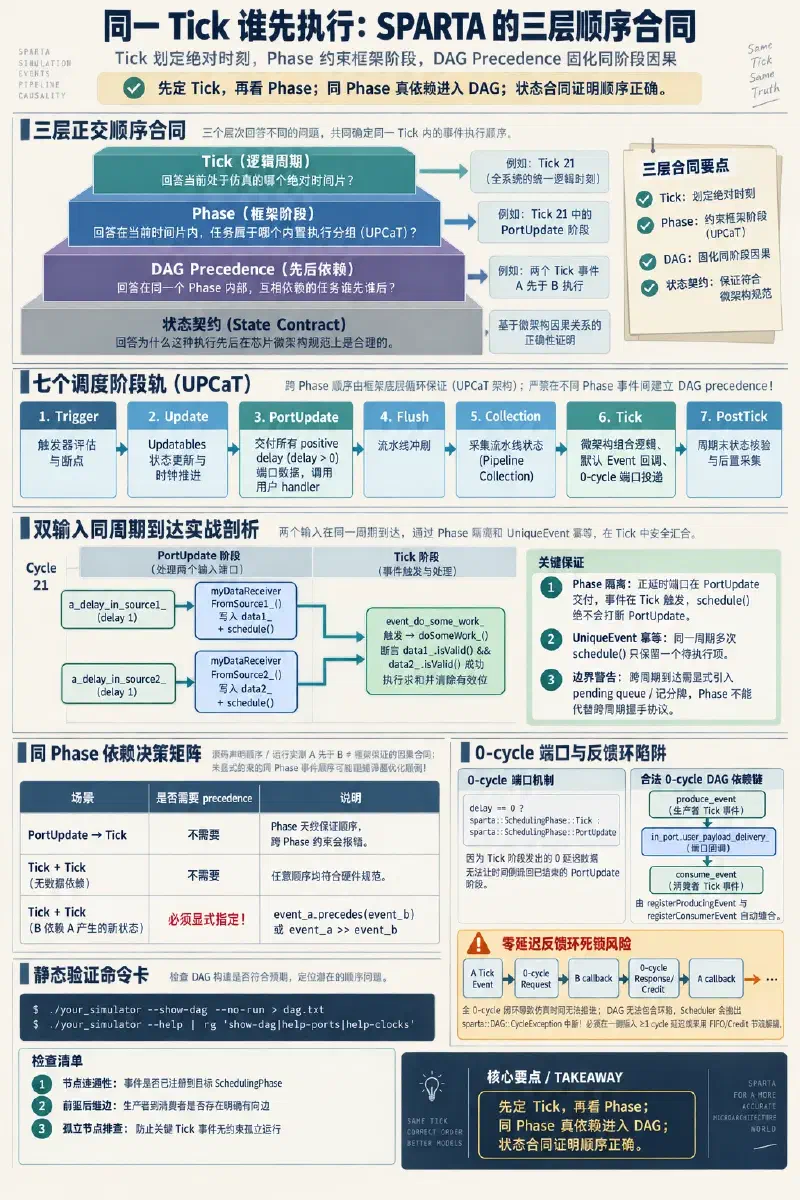
这个直观的案例揭示了 SPARTA 仿真时序体系的三个正交维度:Tick 决定绝对逻辑时刻,Phase 划分同一时刻内的框架阶段顺序,DAG Precedence 约束同一 Phase 内必须稳定的先后依赖。 只有同时确定这三层要素,“事件 A 先于事件 B 执行”才是一条受框架强保证的确定性时序契约。
1. 一个 Tick 内的七个 Scheduling Phase#
在 SPARTA 源码中,同一逻辑 Tick 内的执行流程被严格细分为七个阶段。sparta::SchedulingPhase 枚举的固定定义与调用次序如下:[SRC]
| Phase 顺序 | 名称 | 框架职责与设计定位 |
|---|---|---|
| 1 | Trigger | 框架内部用于触发器评估与调试断点触发的工作阶段 |
| 2 | Update | 更新状态可更新资源(Updatables),例如时钟推进与寄存器前同步 |
| 3 | PortUpdate | 交付所有延时大于 0(delay > 0)的端口数据,调用用户注册的接收 handler |
| 4 | Flush | 执行流水线刷新(Pipeline Flush)等跨阶段清理操作 |
| 5 | Collection | 采集流水线与微架构组件的运行时占用状态(Pipeline Collection) |
| 6 | Tick | 执行大多数微架构组合逻辑操作、默认 Event 回调以及 0-cycle 端口数据交付 |
| 7 | PostTick | 执行 Tick 结束后的操作,例如周期末的状态核验与后置采集 |
这套阶段顺序由 SPARTA 调度器内置的硬性循环驱动,简称为 UPCaT 架构(Updateables → Ports → Collection → Tick [incl. PostTick])。
阶段之间的绝对先后由框架底层自动保证。例如,一个注册在 Update 阶段的事件永远先于 Tick 阶段的事件执行。你不需要、也严禁在两个不同 Phase 的事件之间调用 precedes() 或操作符 >>。 跨阶段强行建立 DAG 依赖会被框架断言拦截或引发逻辑冲突,因为跨阶段的先后关系已经由调度器循环内置了。
这也彻底澄清了一个常见误区:“0-cycle 调度”绝不等于 C++ 语言层面的“绕过调度器直接同步函数调用”。它仅仅表示目标任务仍然安排在当前的逻辑 Tick,但它具体落在哪一个 Phase、相对于同 Phase 内的其他任务何时执行,依然受调度器规则与 DAG 的严密管控。
2. 双输入示例:为什么同周期数据不会发生抢跑#
在官方示例 Events_dual_example.hpp 中,模块定义了两个 delay 为 1 的输入端口:
// 两个输入端口均配置为 1 个周期的传输延迟
a_delay_in_source1_(&unit_port_set_, "a_delay_in_source1", 1),
a_delay_in_source2_(&unit_port_set_, "a_delay_in_source2", 1)
以及两个独立的接收回调,分别负责将数据暂存到 data1_ 与 data2_,并触发同一个用于聚合计算的 UniqueEvent:
void MyDevice::myDataReceiverFromSource1_(const uint32_t & dat) {
    // delay 为 0,期望在当前周期执行
    event_do_some_work_.schedule();
    sparta_assert(!data1_.isValid());
    data1_ = dat;
}

void MyDevice::myDataReceiverFromSource2_(const uint32_t & dat) {
    event_do_some_work_.schedule();
    sparta_assert(!data2_.isValid());
    data2_ = dat;
}
负责求和的工作函数 doSomeWork_() 内部断言两份数据都已就绪:
void MyDevice::doSomeWork_() {
    sparta_assert(data1_.isValid() && data2_.isValid(),
                  "Hey, we didn't get data1 and data2 before this function was called!");
    total_data_ = data1_.getValue() + data2_.getValue();
    data1_.clearValid();
    data2_.clearValid();
}
如果两个数据源在 Cycle 20 的 send() 发生,那么在 Cycle 21 的完整执行链路如下:
- 进入 Cycle 21 的
PortUpdatePhase:- 调度器投递
a_delay_in_source1_的数据,调用myDataReceiverFromSource1_; - 回调执行
event_do_some_work_.schedule(),将工作事件放入待调度队列;随后写入data1_; - 调度器投递
a_delay_in_source2_的数据,调用myDataReceiverFromSource2_; - 回调再次执行
event_do_some_work_.schedule();随后写入data2_。
- 调度器投递
PortUpdatePhase 结束,进入Flush与CollectionPhase;- 进入 Cycle 21 的
TickPhase:- 调度器执行
event_do_some_work_,调用doSomeWork_(); - 函数检测
data1_与data2_均处于 Valid 状态,断言成功,完成加法计算并清除 Valid 标记。
- 调度器执行
这套逻辑之所以绝对不会抢跑,是由框架底层的两个独立契约共同支撑的:
- 契约一:Phase 隔离保证。正延迟(delay ≥ 1)的
DataInPort其投递任务被调度器分配在PortUpdate阶段,而UniqueEvent默认分配在Tick阶段。因此,无论在PortUpdate期间调用多少次schedule(),事件执行都被推迟到Tick阶段,不可能在PortUpdate中断正在接收第二个端口的过程。[SRC] - 契约二:
UniqueEvent幂等保证。UniqueEvent在同一个时钟周期内无论被schedule()调用多少次,在调度队列中只保留一个待执行项,从而天然避免了“输入两次导致计算函数触发两次”的冗余执行。
设计边界警告:这种设计模式严格要求“两个数据源在同一个时钟周期到达”。如果业务逻辑中数据源可能跨周期到达(例如 Source 1 在 Cycle 20 到达,Source 2 在 Cycle 25 到达),那么在 Cycle 20 的 doSomeWork_() 断言必然崩溃。此时模型必须显式引入 Pending 队列、超时窗口或记分牌匹配机制,绝不能把单周期内的 Phase 先后顺序误当成跨周期的握手同步协议。
3. Phase 保证跨组顺序,DAG 保证组内顺序#
如果两个事件位于不同的 Scheduling Phase(例如一个在 Update,一个在 Tick),它们的执行先后由调度器的主循环直接保证。
然而,如果多个可调度对象(Scheduleable)落在同一个 Scheduling Phase 内部,框架默认不根据 C++ 源码的声明顺序、类的构造顺序或函数调用顺序来决定谁先执行。sparta/events/Scheduler.hpp 的权威注释给出了极关键的工程事实:
在同一个 Phase 内未显式建立先后关系的事件,其拓扑排序由内部哈希表与节点指针排布决定。在某一个确定编译出的二进制文件中,多次运行的先后顺序可能是高度一致且复现的;但是一旦调整源码、更换编译器优化等级甚至仅仅增删无关代码,同 Phase 内未约束事件的相对顺序随时可能发生颠倒。 [SRC]
这意味着,下述常见的调试推理在架构审查中是完全不成立的:
实测连续运行了 100 次不同 workload,Event A 永远在 Event B 之前执行
  ≠> 模型契约保证了 A 先于 B
它仅仅证明在当前的特定编译产物与内存布局下,DAG 拓扑排序恰好把 A 放在了前面。如果业务逻辑规定“Event B 必须消费 Event A 在本周期刚刚更新的硬件状态”,那么就必须通过显式 Precedence 将依赖固化到 DAG 中:
// 显式约束同 Phase 内的先后顺序
event_a.precedes(event_b);
// 或者使用更直观的重载操作符
event_a >> event_b;
这两个事件必须位于同一个 SchedulingPhase。若尝试在 Update 阶段的 event_a 与 Tick 阶段的 event_b 之间执行 event_a >> event_b,框架会抛出异常,因为跨阶段依赖属于非法约束。
审查事件先后关系时,可以遵循下表决策:
| 事件 A 与事件 B 的相对关系 | 是否需要显式 Precedence(>>)? | 依据与排查重心 |
|---|---|---|
A 处于 PortUpdate,B 处于 Tick | 否 | Phase 天然保证 A 永远早于 B |
A、B 均处于 Tick,互无数据读写依赖 | 否 | 无依赖,任意顺序均符合硬件规范 |
A、B 均处于 Tick,B 依赖 A 产生的新状态 | 必须显式指定 | 否则换个编译环境或修改源码即可引发偶发时序 Bug |
A、B 均处于 Tick,通过同一 Queue 交互 | 按需指定 | 需审查队首元素是否要求在入队的同周期被立即处理 |
4. 0-cycle Port 为什么进入 Tick 阶段#
sparta::DataInPort 的构造函数中包含一行直接的逻辑判断:[SRC]
DataInPort(portset, name,
           (delay == 0 ? sparta::SchedulingPhase::Tick : sparta::SchedulingPhase::PortUpdate),
           delay)
为什么 0-cycle 端口要打破常规,把投递阶段从 PortUpdate 改到 Tick?
因为在典型的微架构模拟中,发送端口(DataOutPort)的数据产生通常是由某个模块在 Tick 阶段的组合逻辑或事件回调中发起的。如果一个 0-cycle 端口被要求在 PortUpdate 阶段完成投递,由于当前周期已经走到了 Tick 阶段,调度器必须让时间倒流回已经结束的 PortUpdate 阶段,这在逻辑上是无法实现的。因此,0-cycle 端口的投递动作必须顺延安置在当前周期的 Tick 阶段,与驱动它的发送逻辑处于同一阶段内。
这随之带来了新的时序挑战:在 Tick 阶段内部,发送端的逻辑、端口自身的数据分发逻辑、接收端的消费逻辑三者全部处于同一 Phase。如果不加显式约束,接收端可能会先于发送端执行,导致 0-cycle 信号丢失或读取到上一周期的陈旧数据。
为了解决这一问题,SPARTA 在 sparta::Port 接口中提供了专门的依赖注册机制:
- 发送端通过
out_port.registerProducingEvent(produce_event)声明哪个事件负责生产该端口的数据; - 接收端通过
in_port.registerConsumerEvent(consume_event)声明哪个事件负责消费该端口的数据。
当 Simulation::bindTree_() 将两个端口绑定(sparta::bind())时,框架会自动在底层 DAG 中建立精确的有向连接:[SRC]
produce_event (生产者 Tick 事件)
      ↓ (DAG precedence)
in_port.user_payload_delivery_ (端口内部数据派发实体)
      ↓ (DAG precedence)
consume_event (消费者 Tick 事件)
通过这套自动注册的 DAG 边,SPARTA 确保了即使三者都挤在同一个 Tick 的 Tick Phase,执行次序也必然是:生产事件运行并 send() → 端口内部投递数据并调用接收 handler → 消费事件读取最新数据运行。这在保持 0 周期组合逻辑直通的同时,彻底消除了未定义排序风险。
5. 什么时候会形成零延迟反馈环#
零延迟路径在表达握手信号(Ready-Valid)或反向流控(Credit 实时反馈)时不可或缺,但也极易引发模拟器死锁或调度器无限循环(Livelock)。
最典型的故障场景是同周期内的双向闭环触发:
Unit A 在 Tick 阶段执行 event_a_
  → 发送 0-cycle Request 到 Unit B
  → Unit B 的接收回调在当前 Tick 立即执行
  → Unit B 在回调中通过 0-cycle Port 立即回传 Response/Credit 给 Unit A
  → Unit A 的接收回调在当前 Tick 再次执行
  → Unit A 在回调中再次触发 0-cycle Request...
只要每次回调都直接调用下游端口的 send() 且总延迟为 0,调度器在当前 Tick 就会源源不断地收到新的调度请求,导致模拟时间永远无法推进到下一个 Cycle。
更致命的是,Precedence 无法解决真实存在的业务逻辑死锁。 SPARTA 的调度图必须是严格的有向无环图(DAG)。如果你试图通过 precedes() 来理顺上述闭环,Scheduler 在 Simulation::finalizeFramework() 阶段构建图时会立即检测到强连通分量,并抛出 sparta::DAG::CycleException 中断程序运行。[SRC]
在微架构建模中,消除零延迟反馈环的四种标准工程方案如下:
- 破环延迟化(Positive Delay Insertion):在闭环链路中,至少保证一侧路径(通常是反向的 Response 或 Credit 释放路径)具有大于等于 1 个时钟周期的物理延时。这最符合实际硬件寄存器打拍的行为。
- 两阶段解耦(Enqueue & Postpone):接收端的回调函数在被调用时只负责将事务压入待处理队列(FIFO),严禁在回调内部同步调用下游发送;另起一个关联 delay ≥ 1 事件去取出队列内容并发送。
- 配额节流控制(Credit / Token Throttling):如果必须保留 0-cycle 直通,必须设置严格的单周期最大吞吐阈值或 Credit 配额池,当单周期处理事务数达到上限时强行阻断连续触发。
- 状态合并更新(State Coalescing):将分散的即时响应合并为周期末的统一状态刷新,避免在端口事件之间形成深层递归调用。
无论采取哪种方案,都必须基于所建模芯片的实际硬件微架构规范,不能为了消除模拟器报错而盲目随意添加 1-cycle delay,否则会彻底篡改模型的吞吐与延迟保真度。
6. 怎样从源码写出一条完整时序结论#
在撰写模块时序设计说明或审阅时序 Bug 时,仅仅在文档中记录“该请求延时为 2 个周期”是严重失职的。一条经得起代码核验的时序结论必须覆盖以下八个关键要素:
| 关键要素 | 审计核验内容 | 源码定位依据 |
|---|---|---|
| Clock Domain | 该延迟究竟以哪个节点的 Clock 为基准(例如 Core 时钟还是 NOC 时钟) | TreeNode::getClock() |
| Send Site | 发送动作在哪个源文件的哪个函数发起 | port.send(data) 的调用位置 |
| Port Delay | 端口本身的静态配置延迟是 0 还是正整数 | DataInPort / DataOutPort 构造参数 |
| Delivery Phase | 数据在目标周期的哪个 Phase 完成交付 | delay == 0 ? Tick : PortUpdate |
| Receiver Handler | 接收端具体挂载了哪个 C++ 成员函数作为回调 | registerConsumerHandler() |
| Downstream Event | 回调函数内部是否调度了新事件,其 delay 和 phase 是多少 | event.schedule(delay) |
| DAG Precedence | 同 Phase 内的先后顺序是由哪条显式语句或绑定规则确定的 | >> 或 registerConsumerEvent() |
| State Mutation | 队列深度、Credit 计数器或 Busy 标志位在哪个时刻完成变更 | 变量赋值与清除有效位的代码点 |
例如,基于 Events_dual_example.hpp 的完整且严谨的时序结论应表述为:
输入端口
a_delay_in_source1_与a_delay_in_source2_的配置延时均为 1,且均挂载在设备时钟域下。在目标周期的PortUpdatePhase,调度器依次调用接收回调函数;回调函数将载荷写入ValidValue容器,并以 delay 0 调度属于TickPhase 的event_do_some_work_;进入TickPhase 后,聚合事件触发并执行断言校验与求和逻辑,随后清除数据的有效标志。[SRC]
这样的表述将时钟周期、阶段归属、数据流向、事件状态与边界约束完整融合,杜绝了含糊不清的推论空间。
7. 用 DAG 输出核对显式顺序#
当你不确定多个事件在同一个 Phase 内的先后顺序是否真的被 DAG 保护时,不要仅凭脑海中的推演。保留标准 CommandLineSimulator 接口的模拟器提供了直接导出调度 DAG 的功能:
# 导出当前模型完整的调度 DAG,并在进入事件循环前退出
./your_simulator --show-dag --no-run > dag.txt
如果模型的二进制封装屏蔽了默认参数,可以先过滤帮助文本寻找对应选项:
./your_simulator --help | rg 'show-dag|help-ports|help-clocks'阅读导出的 dag.txt 时,重点核验以下三项指标:
- 节点连通性:目标事件是否已成功注册为调度器中的
Scheduleable?它被分配在哪个SchedulingPhase集合中? - 前驱与后继边:预期的生产者事件到消费者事件之间,是否存在直接或传递的有向依赖边?
- 孤立节点排查:是否存在某个需要严格按顺序执行的
Tick事件,在图上却没有任何入边或出边?如果存在,该事件的执行时序完全取决于编译器的偶然排布,必须立即补充 Precedence。
最后,始终在脑海中保留清晰的四层时序心智模型:
Tick (逻辑周期)   =>  回答“当前处于仿真的哪个绝对时间片”
Phase (框架阶段)  =>  回答“在当前时间片内,任务属于哪个内置执行分组 (UPCaT)”
DAG (先后依赖)    =>  回答“在同一个 Phase 内部,互相依赖的任务谁先谁后”
状态契约          =>  回答“为什么这种执行先后在芯片微架构规范上是合理的”
下一篇将把这些静态的结构与时序规则落实为一套完整的动态可观测性方法:如何在不盲目打印海量日志的情况下,从低成本的结构静态导出逐步进阶到 Counter、Logger、PEvent 与 Pipeline Collection 的分层调试。
本文采用 CC BY-NC-SA 4.0 许可。