阅读信息
- 内容类型:教程
- 难度:中级
- 依据版本:MAP 9d8ec03c0e118820e1093831b9060d8d17164d8d
- 验证日期:2026-08-24
在阅读或调试 SPARTA 仿真模型时,经常会遇到直觉与运行事实相悖的情况:源码中定义了 producer_out_port,并不保证本次运行参数真的实例化了该 Producer;头文件中写着队列深度默认是 8,并不保证配置文件没有将其覆盖为 2;某个回调函数理论上可以处理数据,并不保证目标 workload 实际触发了这一路径。
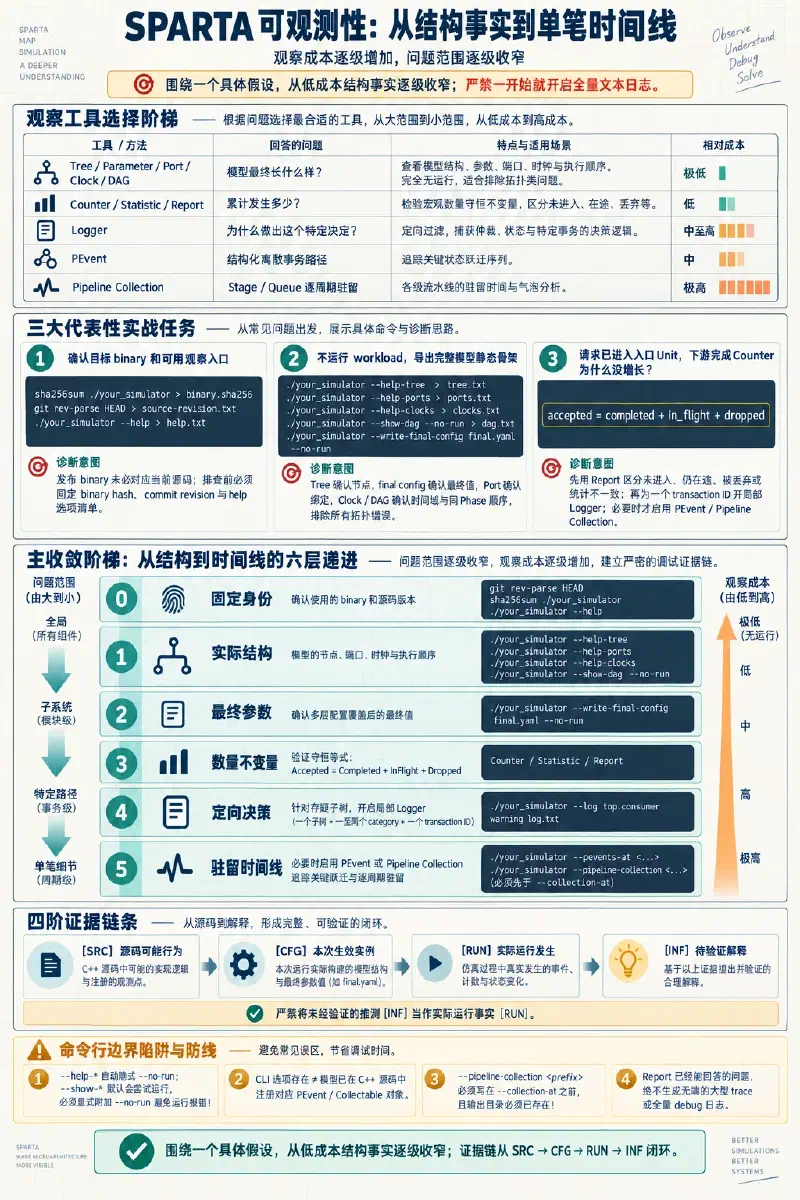
高效审查与调试 SPARTA 模型,必须将三类正交问题彻底拆开:
- 模型最终长什么样? 依靠 Tree、Parameter、Port、Clock 和 DAG 核对静态结构;
- 仿真运行后累计发生了多少? 依靠 Counter、Statistic 和 Report 检验数量不变量;
- 某一笔具体事务如何流经微架构? 依靠 Logger、PEvent 或 Pipeline Collection 追踪生命周期。
本文基于固定提交 9d8ec03c 的 sparta::app::CommandLineSimulator,梳理一条从零副作用静态导出逐步深入到高精度动态追踪的观察路径。所有工具与选项均源自框架原生实现;实际工程中上层脚本或封装二进制可能会增删参数,因此排查的第一步永远是检查目标二进制自身的 --help。[SRC]
1. 建立观察工具的选择阶梯#
排查问题最忌讳一开始就打开全量调试日志。无节制的全量文本日志不仅会使仿真速度下降数个数量级,还会让真正的问题根因淹没在数千万行无关输出中。不同观察工具解决的问题与适用层级截然不同:
| 排查目标 | 首选工具 | 输出形式与证据产物 | 性能开销 |
|---|---|---|---|
| 模块是否存在、树路径与层次关系 | Device Tree | 树形文本结构 | 极低(可无运行) |
| 各参数最终生效数值与覆盖来源 | Parameter + final config | 参数树、YAML 配置文件 | 极低(可无运行) |
| 端口物理连接拓扑与延迟设置 | Port 自省 | 端口树与绑定映射表 | 极低(可无运行) |
| 时钟域归属与频率换算关系 | Clock 树 | 时钟节点与比例关系 | 极低(可无运行) |
| 同一 Phase 内的事件先后调度顺序 | Scheduler DAG | DOT 图或文本拓扑边 | 极低(可无运行) |
| 某一类行为或异常累计发生的次数 | Counter / Report | 统计汇总报告(TXT/HTML/SimDB) | 低 |
| 某个模块内部为什么做出仲裁或丢弃决策 | Logger | 附带 Category 的过滤文本流 | 中至高 |
| 离散事务在各组件发生的起止时间戳 | PEvent | 结构化二进制/文本事件序列 | 中 |
| 事务在多级流水线各 Stage 的驻留周期与 Stall 分布 | Pipeline Collection | 时间线文件(ALF / 数据库) | 极高 |
黄金准则:先用成本最低、确定性最高的静态自省工具排除拓扑与配置错误;再用统计报告验证宏观守恒律;最后仅针对存疑的局部子树与具体事务开启细粒度动态追踪。
2. 检查目标二进制实际支持的自省入口#
调试工作必须从确认二进制的实际接口开始:
# 导出完整的命令行帮助文本
./your_simulator --help > help.txt

# 检索观察与诊断相关的核心开关
rg -n 'show-|help-|final-config|report|log|pevent|collection' help.txt
在 SPARTA 原生 CommandLineSimulator 中,标准的诊断自省开关包括两类:[SRC]
--no-run                               # 完成组装后直接以状态码 0 退出,不运行仿真
--show-tree         / --help-tree      # 打印各阶段设备树结构
--show-parameters   / --help-parameters# 打印配置完成后的参数树
--show-ports        / --help-ports     # 打印 Finalize 后的端口连接
--show-counters     / --help-counters  # 打印注册的 Counter 与 Statistic
--show-loggers      / --help-loggers   # 打印注册的 Logger 节点
--show-clocks       / --help-clocks    # 打印时钟树拓扑
--show-dag                             # 打印运行前的调度 DAG
--help-pevents # 打印模型支持的 PEvent 类型关键语义区别:
--help-*系列开关(如--help-tree、--help-parameters)在框架内部会自动隐式设置--no-run,打印对应结构后立即安全退出;--show-*系列开关(如--show-tree、--show-ports)默认会在打印结构后继续尝试运行工作负载。因此,如果只想进行纯静态审查,必须显式附加--no-run参数,避免由于缺少输入数据或配置不完整导致运行报错。
如果目标二进制中找不到某个标准选项,应当核查:
- 实际运行的是发布版包装脚本还是原生二进制;
- 项目固定的 SPARTA 框架版本是否早于该选项引入时间;
- 模型源码中是否根本没有实例化该类对象(例如没有任何模块注册 PEvent)。
3. 零开销导出静态模型骨架#
在挂载任何真实工作负载之前,按照以下顺序执行静态检查并保存产物:
# 1. 导出设备树拓扑
./your_simulator --help-tree > tree.txt

# 2. 导出参数配置表
./your_simulator --help-parameters > parameters.txt

# 3. 导出端口物理连接
./your_simulator --help-ports > ports.txt

# 4. 导出时钟域层次
./your_simulator --help-clocks > clocks.txt

# 5. 导出调度依赖图
./your_simulator --show-dag --no-run > dag.txt
这五份静态输出构成互相印证的基线证据:
Tree:验证实体存在性与路径命名空间#
tree.txt 显示了设备树的绝对命名空间。后续所有的 -p 参数覆盖、--log 节点匹配、--report 挂载路径均以此为唯一基准。如果发现配置项未生效或日志无输出,首先到 tree.txt 中核对该节点是否存在、路径大小写是否完全一致。
Parameter 与 Final Config:确立本次运行的参数事实#
--help-parameters 输出了设备树上所有参数的键值与类型。但在多层配置覆盖下,最权威的实验审计证据是导出 final.yaml:
./your_simulator \
  --write-final-config final.yaml \
  --no-run
若需连同每个参数的头文件描述、合法值范围一并存档,使用详细模式:
./your_simulator \
  --write-final-config-verbose final-verbose.yaml \
  --no-run
final.yaml 真实反映了源码默认值、--arch 基线、所有 -c 配置文件与 -p 覆盖合并后的最终结果。比较两次性能差异时,必须比对两份 final.yaml 的 diff,而不是仅凭启动脚本命令行。
Port:确认通信连线与延迟契约#
ports.txt 显示了每个 Unit 实际导出的端口名称以及它所绑定的目标端口路径。结合头文件中的 DataInPort / DataOutPort 泛型类型与配置延迟,可确认通信网络是否形成闭环,是否存在悬空的未绑定关键端口。
Clock 与 DAG:确认时间基准与同 Phase 依赖#
clocks.txt 列出各节点的时钟频率与父子分频关系。dag.txt 展现了所有可调度对象(Scheduleable)的有向边。若业务上两个 Tick 事件存在前因后果,但 DAG 中两者之间无依赖边,说明其先后完全由编译器内存布局随机决定,存在潜在时序风险。
4. 用 Counter 与 Report 回答“累计发生了多少”#
在微架构建模中,sparta::Counter 用于记录标量累加事件(如接收请求数、命中次数),而 sparta::StatisticDef 用于基于 Counter 计算衍生指标(如 IPC、命中率)。
SkeletonPipeline 展示了最基础的计数器定义:[SRC]
// Producer 中定义生成数量
sparta::Counter num_produced_{
    &unit_stat_set_, "num_produced",
    "Number of items produced",
    sparta::Counter::COUNT_NORMAL};

// Consumer 中定义消费数量
sparta::Counter num_consumed_{
    &unit_stat_set_, "num_consumed",
    "Number of items consumed",
    sparta::Counter::COUNT_NORMAL};
首先使用自省命令了解当前模型暴露了哪些统计项:
./your_simulator --help-counters > counters.txt在运行仿真时,生成全局统计汇总的标准命令为:
# 生成全局报告,保存为文本格式
./your_simulator \
  --report-all stats.txt \
  <workload_args...>
如果只关心某个特定子树,或者需要自定义报告模板,可采用带模式匹配的 --report 语法:[SRC]
# 语法 1:使用 @ 符号自动提取目标子树下的所有统计量
./your_simulator \
  --report top.consumer @ consumer_stats.txt \
  <workload_args...>

# 语法 2:使用预定义的 report yaml 模板抽取指定指标
./your_simulator \
  --report top.consumer report_def.yaml consumer_stats.txt txt \
<workload_args...>底层更新机制与排错陷阱:
Counter 的累加不是框架自动发生的,它完全依赖开发人员在 C++ 代码中显式执行 ++counter_ 或 counter_ += n。审查统计量时,绝不能只根据名称(如 num_completed)推测其物理含义;必须在代码中精准定位其增量发生的语句:
- 它是代表“请求进入内部队列”,还是“请求完成物理传输”,抑或是“收到对方的 Response”?
- 如果出现统计异常,首先核对调用计数器增量的那个分支条件是否被意外跳过。
5. 用 Logger 回答“为什么做出特定决定”#
当 Counter 发现数量不一致时,需要深入模块内部理清仲裁与控制流逻辑。SPARTA 的 Logging 体系基于节点路径模式匹配与 Category 过滤机制。
查看模型支持的 Logger 节点:
./your_simulator --help-loggers > loggers.txt标准日志参数格式为:--log <PATTERN> <CATEGORY> <DEST>。[SRC]
# 示例 1:仅抓取 consumer 节点的 warning 日志并写入文件
./your_simulator \
  --log top.consumer warning consumer_warn.log \
  <workload_args...>

# 示例 2:针对所有 producer 节点抓取 info 日志,输出到标准输出 (1)
./your_simulator \
  --log 'top.producer*' info 1 \
  <workload_args...>

# 示例 3:监听整棵子树的所有 category ('*'),输出到标准错误 (2)
./your_simulator \
  --log 'top.consumer.*' '*' 2 \
  <workload_args...>
Logger 的最佳实践:
- 范围最小化:严禁在根节点挂载全量日志(如
--log '*' '*' debug.log)。应将 PATTERN 限制在发生异常的具体子树,并将 CATEGORY 锁定在与该异常直接相关的类别(如pipeline、hazard或credit)。 - 锚定事务标记:在输出格式中尽可能打印事物唯一标识(如 Transaction ID、虚拟地址或 Sequence Number),以便利用
grep快速抽取出单笔请求的因果链条。
6. PEvent 与 Pipeline Collection 的场景划分#
这两者均属于高级动态追踪工具,但建模目标与数据模型存在本质区别。
PEvent:结构化离散事件流#
PEvent 面向离散事务(Transaction)的关键状态跃迁点(如 Allocate、Dispatch、Commit、Retire)。
# 收集全局指定类别事件
./your_simulator \
  --pevents events.log ALL \
  <workload_args...>

# 针对指定子树收集特定类型事件
./your_simulator \
  --pevents-at lsu_events.log top.core0.lsu ALL \
  <workload_args...>
PEvent 输出的是紧凑的事件记录,天然适合配合脚本进行自动化数据清洗、时延分布直方图绘制或异常事务追踪。前提是模型在 C++ 源码中已通过 sparta::pevents API 显式埋点。
Pipeline Collection:微架构驻留与时间线视图#
Pipeline Collection 面向流水线中每个阶段(Stage)、缓冲队列(Queue)在每一个时钟周期对事务的物理占用情况。
# 必须先指定输出路径前缀,再指定开启采集的目标节点
./your_simulator \
  --pipeline-collection data/run1_ \
  --collection-at top.core0.pipeline \
<workload_args...>命令行陷阱提示:在 SPARTA 原生实现中,--pipeline-collection 选项必须写在 --collection-at 之前,且指定的输出目录(如 data/)必须在宿主机上预先存在,否则解析逻辑会当场抛出异常中断。[SRC]
工具对比如下:
| 特性维度 | Report 统计报告 | Logger 文本日志 | PEvent 结构化事件 | Pipeline Collection 流水线追踪 |
|---|---|---|---|---|
| 时间敏感度 | 无时间戳(周期末归总) | 带时间戳文本 | 带精确时间戳 | 逐周期连续时间线 |
| 数据形态 | 键值对数值 | 非结构化文本 | 紧凑键值元组 | 阶段驻留状态数据库 |
| 性能开销 | 极低(仅增量计算) | 取决于文本 I/O | 中等 | 极高(海量存储) |
| 适用诊断 | 吞吐率、总量核对 | 仲裁失败、状态转移原因 | 跨模块事务流向追踪 | 流水线 Stall、流水线气泡分析 |
7. 闭环调试工作流:从假设到证据包#
面对性能不符或死锁等微架构问题,建议遵循以下五层收敛工作流:
层级 0:锁定二进制与代码版本(git rev-parse、sha256sum、--help)
  ↓
层级 1:导出无运行静态结构(--help-tree、--help-ports、--help-clocks、--show-dag)
  确认拓扑是否完整、端口是否绑定、时钟是否正确、DAG 是否有断链
  ↓
层级 2:导出最终生效参数(--write-final-config final.yaml --no-run)
  核验队列深度、延迟数值、仲裁开关是否符合本次实验预期
  ↓
层级 3:基于 Report 验证数量不变量
  建立守恒等式:Accepted == Completed + InFlight + Dropped
  定位流失环节属于未流入、处理中阻塞还是内部丢弃
  ↓
层级 4:定向开启局部 Logger
  针对守恒断裂的特定子树与 Category,追踪单笔事务的转移条件
  ↓
层级 5:高精度 PEvent / Pipeline Collection
  针对难以复现的时序毛刺或复杂的流水线反压,生成周期级驻留时间线
8. 构建可复查的调试证据包#
一次具有工程说服力的 Bug 报告或架构决策记录,绝不能只附带一份杂乱的终端截屏。规范的证据目录结构如下:
audit-case-001/
├── binary.sha256           # 仿真二进制校验和
├── source-revision.txt     # Git Commit 哈希与未暂存 Diff 说明
├── command.txt             # 完整执行命令行(含全部参数)
├── help.txt                # 该二进制的实际 --help 导出
├── tree.txt                # 静态设备树结构
├── ports.txt               # 端口物理绑定记录
├── clocks.txt              # 时钟域配置记录
├── dag.txt                 # 调度 DAG 拓扑
├── final.yaml              # 运行前导出的完整有效配置
├── stdout.log              # 标准输出
├── stderr.log              # 标准错误
├── exit-code.txt           # 程序退出码
├── report.txt              # 仿真结束生成的全局统计报告
└── traces/ # (按需包含)过滤后的局部 Logger 或 PEvent 输出环境与证据边界说明:
在当前的写作与验证环境中,本地工作区仅保有固定提交 9d8ec03c 的 SPARTA 原生源代码,未提供已完成编译的独立测试可执行文件,且编译环境缺少 yaml-cpp 开发库支持,因此本文所有命令与输出规范均直接以该提交的 CommandLineSimulator.cpp 源码实现为依据,不凭空编造虚假的终端运行日志。[SRC]
在实际项目中使用时,通过依次落实现场真实生成的结构文件、最终配置与统计报告,即可在不触碰繁杂猜测的前提下,完成严密且经得起长期审计的模型质量复核。
本文采用 CC BY-NC-SA 4.0 许可。